 主页
class
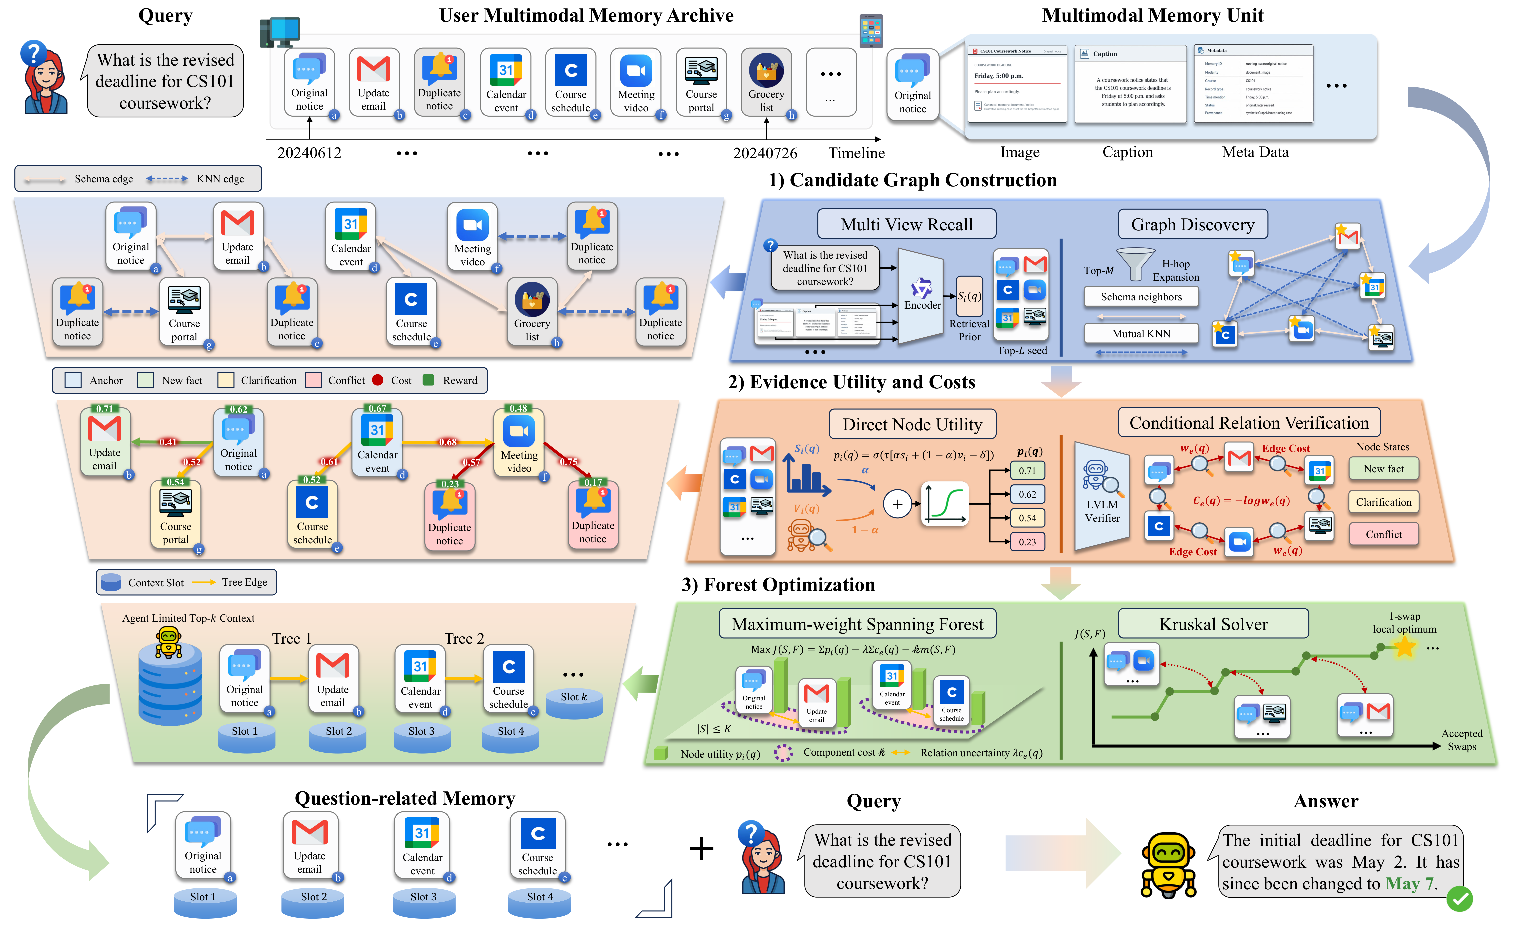
- 面向个人智能助手的多模态视觉记忆技术: 人脑的长期视觉记忆让我们能认出熟悉的人、自己的物品和去过的场景,这是日常生活中最自然的能力之一。然而,随着手机相册、聊天记录、邮件等个人数据不断累积,AI 助手却仍然“记不住”用户:现有多模态智能体的记忆大多依赖通用语义匹配,能找到“狗的照片”,却分不清“我家狗的照片”;面对“上次组会和细粒度相关的照片”这样的复杂指令,手机自带的相册搜索也往往无能为力。为此,本成果聚焦于面向个人智能助手的多模态视觉记忆技术,重点突破了 3 项核心能力:
- Geng Li, Yuhao Wang, Dong Li, Jianye Hao and Yuxin Peng*, "GraphMemix: Query-Aware Evidence Forests for Long-Term Multimodal Agent Memory", arXiv, Aug. 2026.
- 面向下一代智能终端的细粒度感知与记忆技术: 随着AI硬件不断发展,机器人、AI眼镜等终端正成为下一代智能交互的重要载体。人们需要的不再是“一问一答”的工具,而是能够持续感知环境、记住共同经历的智能伙伴。为此,本成果聚焦于面向下一代智能终端的细粒度感知与记忆技术,重点突破了2项核心能力:
- Sibo Yin and Yuxin Peng*, "Learning Fine-Grained Vision-Language Alignment from Discriminative Part Descriptions", The Fortieth Annual Conference on Neural Information Processing Systems (NeurIPS), 2026. (Accept)
- Zhi Tan, Hulingxiao He and Yuxin Peng*, "Uncertainty-Aware Listwise Reinforcement Fine-Tuning for Fine-Grained Visual Classification", The Fortieth Annual Conference on Neural Information Processing Systems (NeurIPS), 2026. (Accept)
- Hulingxiao He, Zhi Tan and Yuxin Peng*, "Learning Taxonomy on Hyperbolic Manifolds for Large Multimodal Models", Forty-Third International Conference on Machine Learning (ICML), Seoul, South Korea, Jul. 6-11, 2026. (Accept)【pdf】【source code】
- Hulingxiao He, Zhi Tan and Yuxin Peng*, "Taxonomy-Aware Representation Alignment for Hierarchical Visual Recognition with Large Multimodal Models", The IEEE/CVF Conference on Computer Vision and Pattern Recognition 2026 (CVPR), Denver CO, USA, Jun. 3-7, 2026. 【pdf】【source code】【CVPR海报】【AI科技评论报道】【量子位报道】【极市平台报道】【CVer报道】
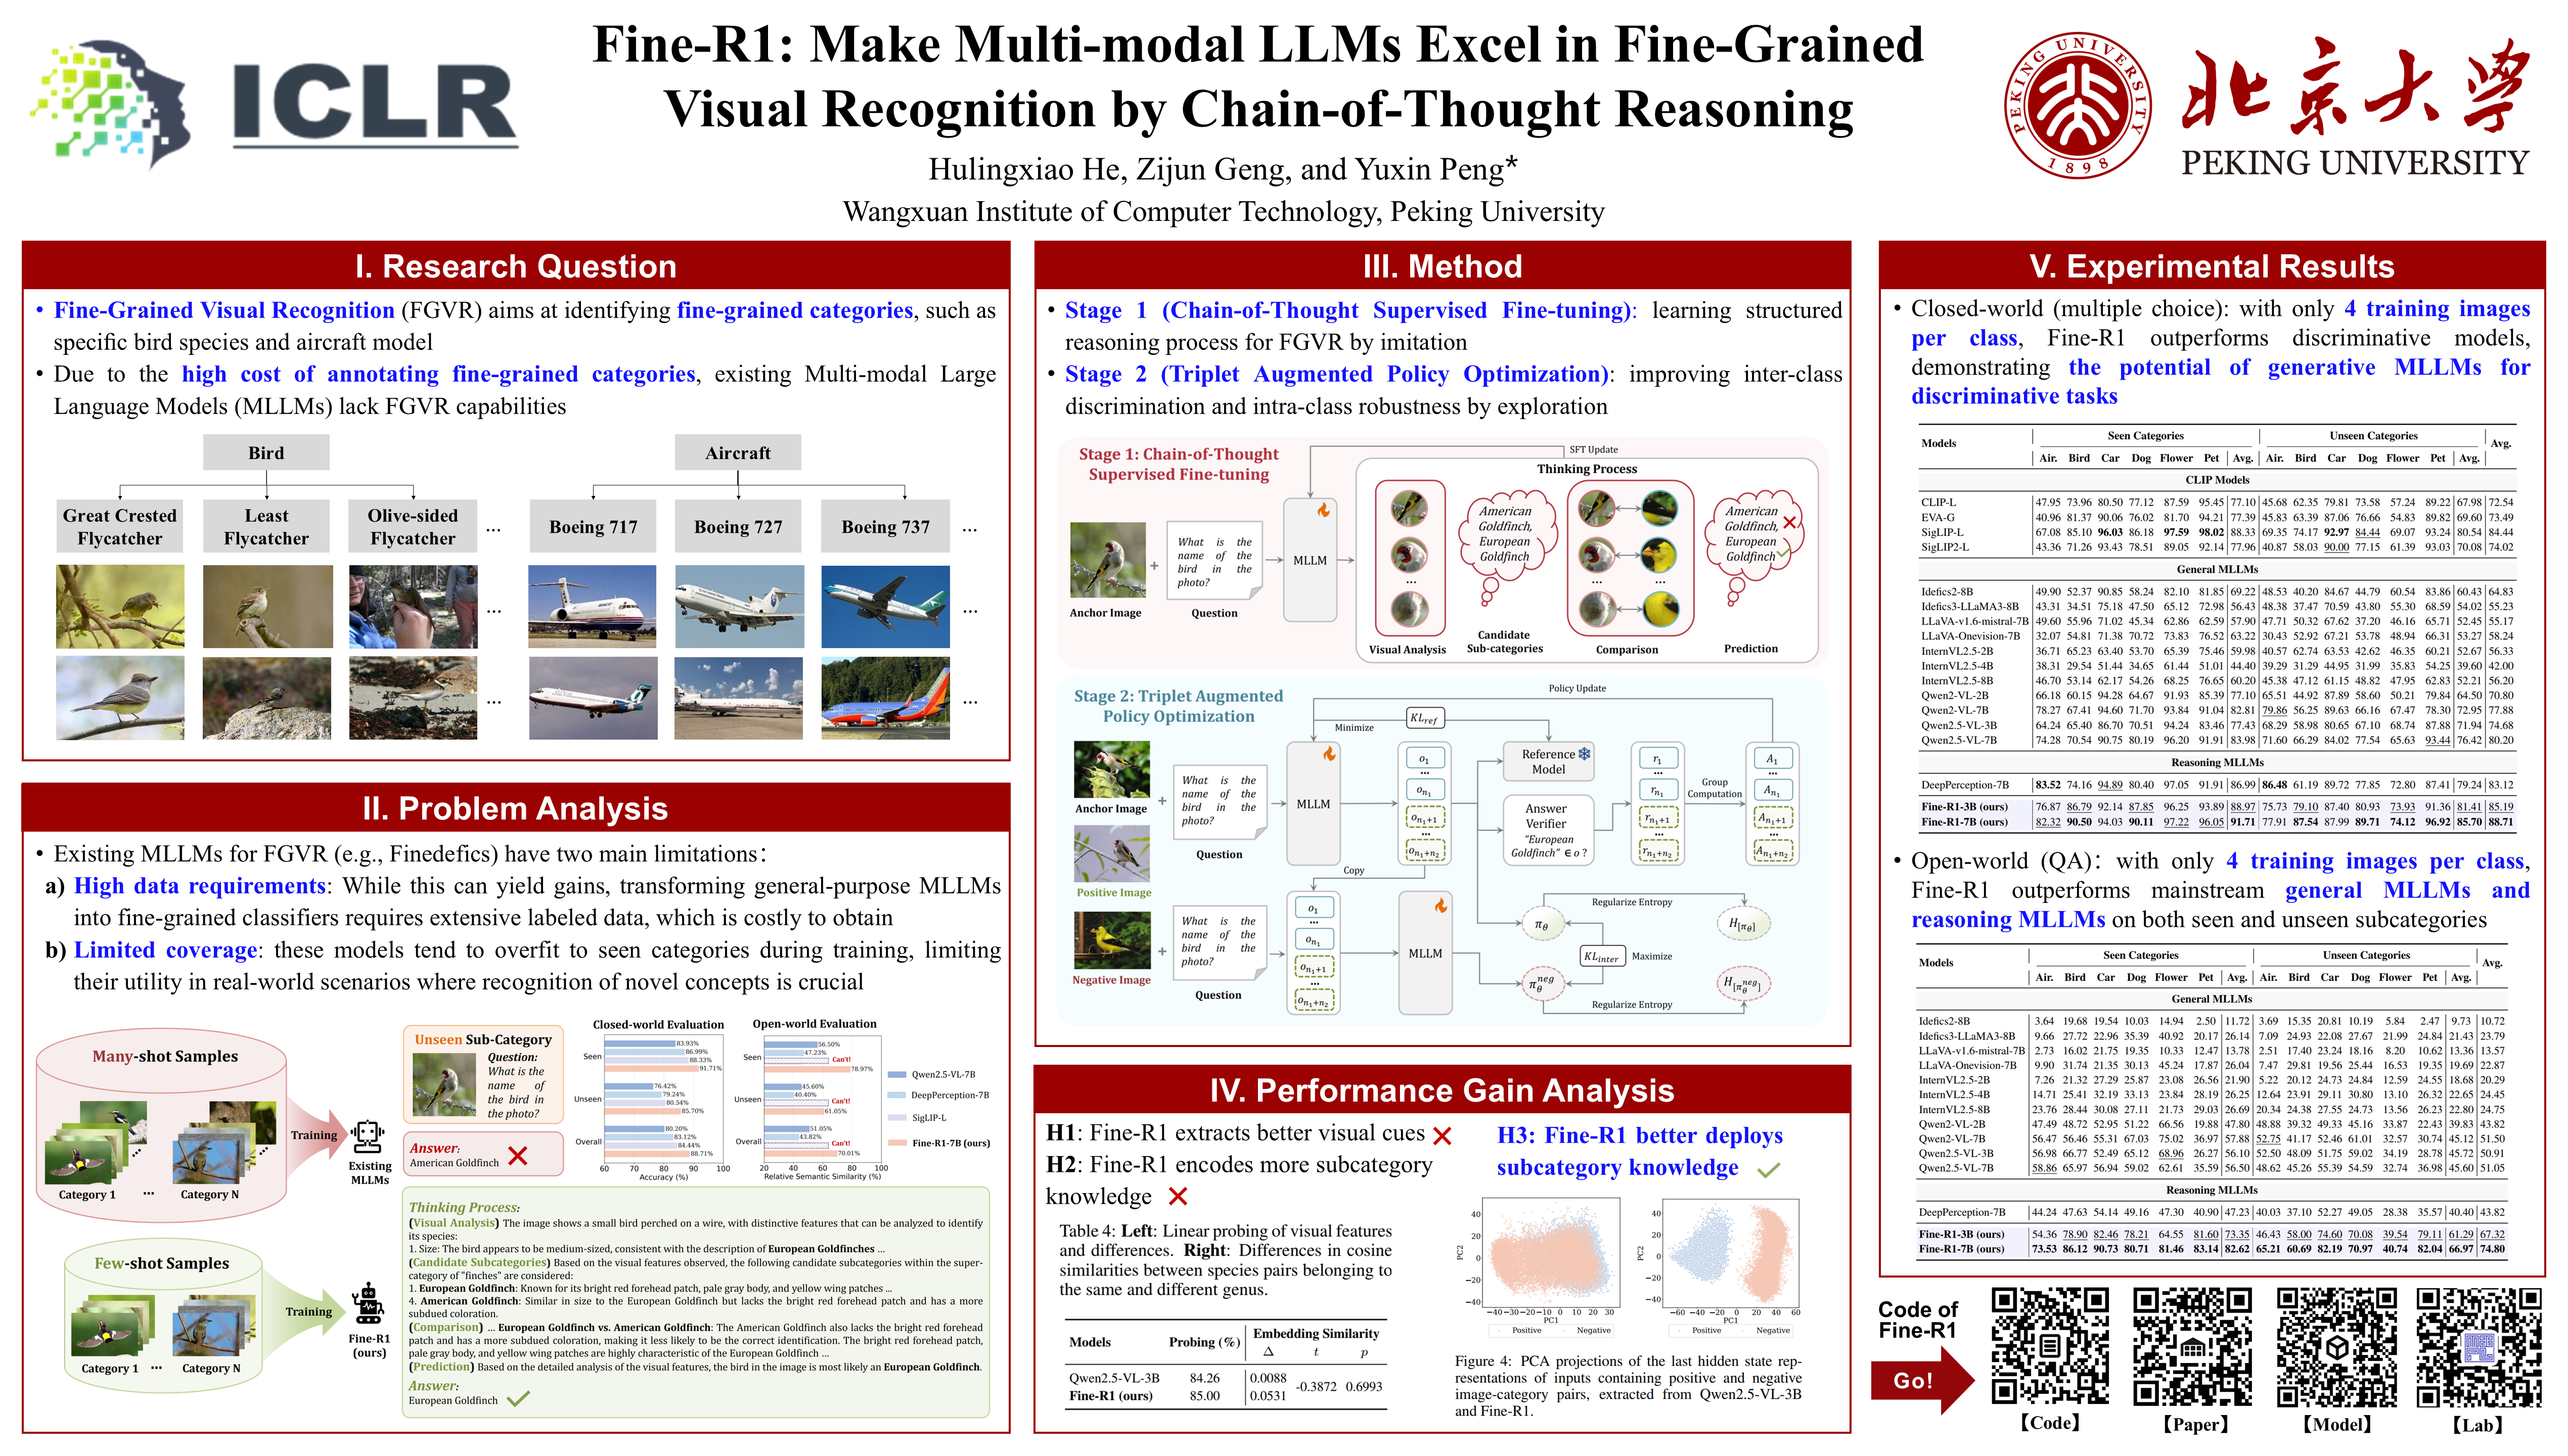
- Hulingxiao He, Zijun Geng and Yuxin Peng*, "Fine-R1: Make Multi-modal LLMs Excel in Fine-Grained Visual Recognition by Chain-of-Thought Reasoning", The Fourteenth International Conference on Learning Representations (ICLR), Rio de Janeiro, Brazil, Apr. 23-27, 2026. 【pdf】【source code】【量子位报道】【极市平台报道】【CVer报道】【宣传海报】【Slides】【Valse海报】【CCIG海报】
- Hulingxiao He, Geng Li, Zijun Geng, Jinglin Xu and Yuxin Peng*, "Analyzing and Boosting the Power of Fine-Grained Visual Recognition for Multi-modal Large Language Models", The Thirteenth International Conference on Learning Representations (ICLR), Singapore, Apr. 24-28, 2025. 【pdf】【source code】【model】【CSIG报道】【机器之心报道】【宣传海报】【Slides】
- 细粒度知识获取评测基准FIKA-BENCH(2026年5月发布,已被康奈尔大学、Apple、腾讯、INSAIT等7个机构使用)
- 国际首个细粒度跨媒体数据集和评测基准PKU FG-Xmedia(2019年10月发布,已被卡内基梅隆大学、麻省理工学院、谷歌、微软等138个机构使用)
- 大规模跨媒体数据集和评测基准PKU Xmedia & XmediaNet(2014年6月发布,已被斯坦福大学、卡内基梅隆大学、微软等409个机构使用)
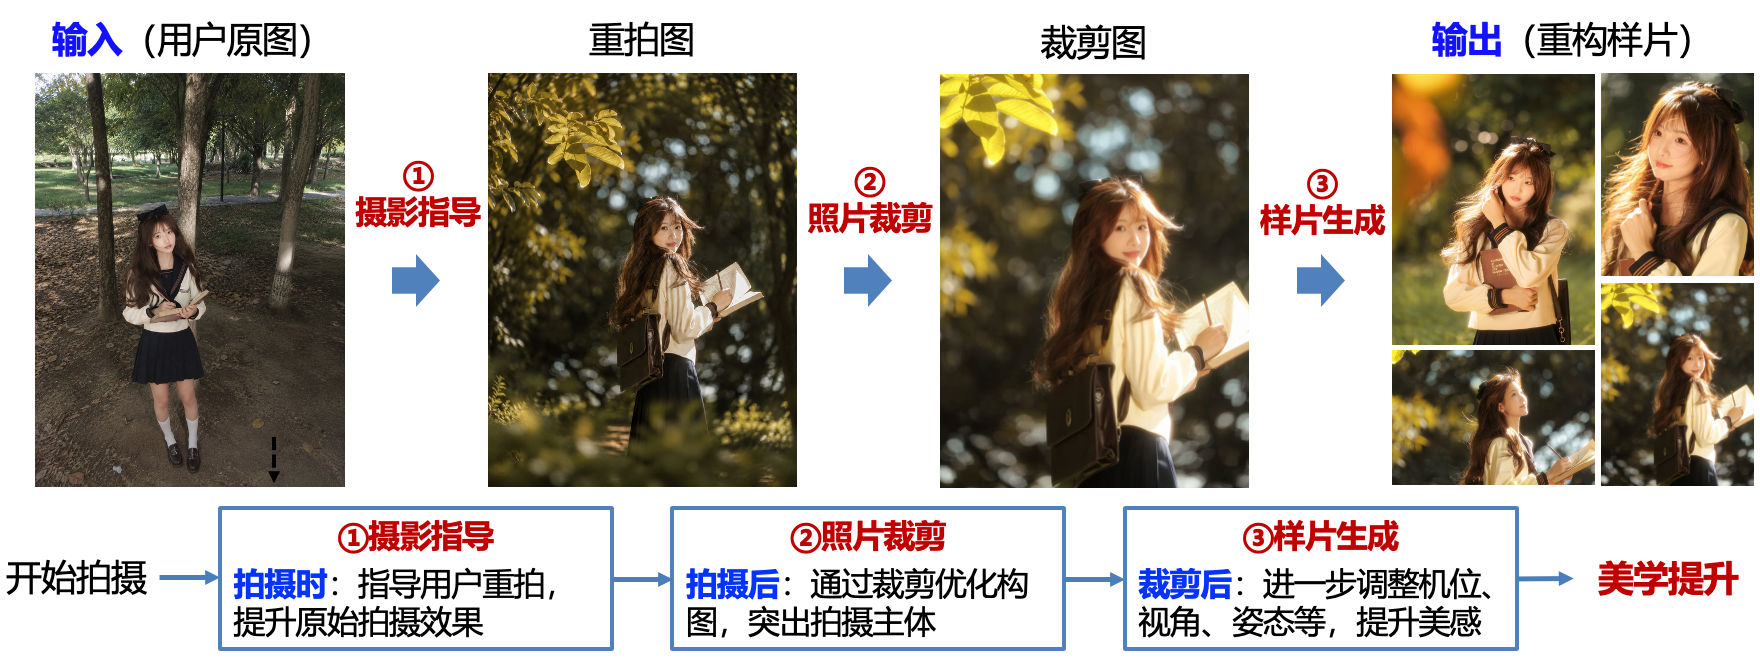
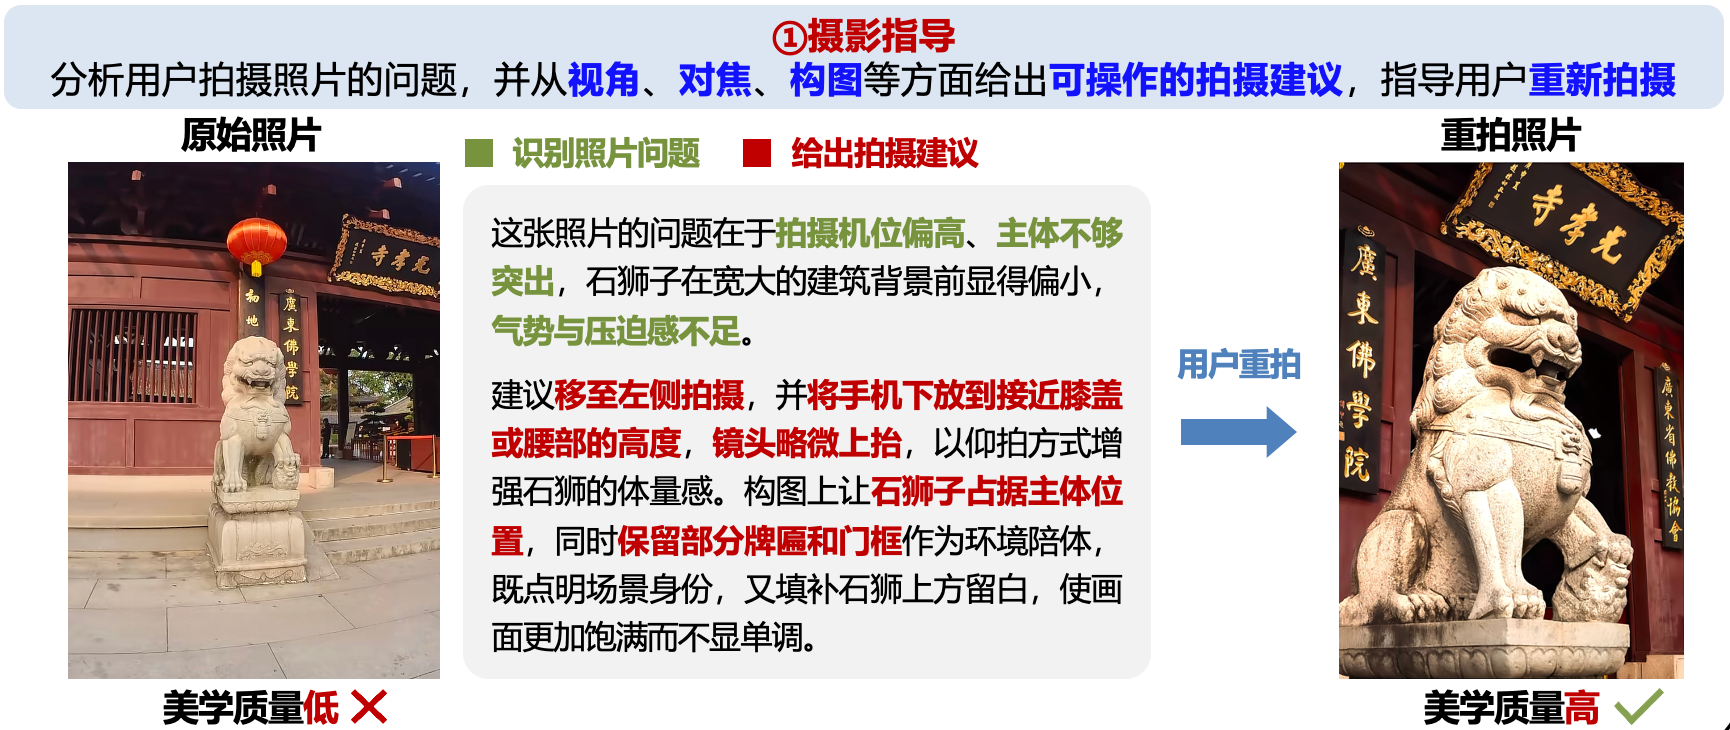
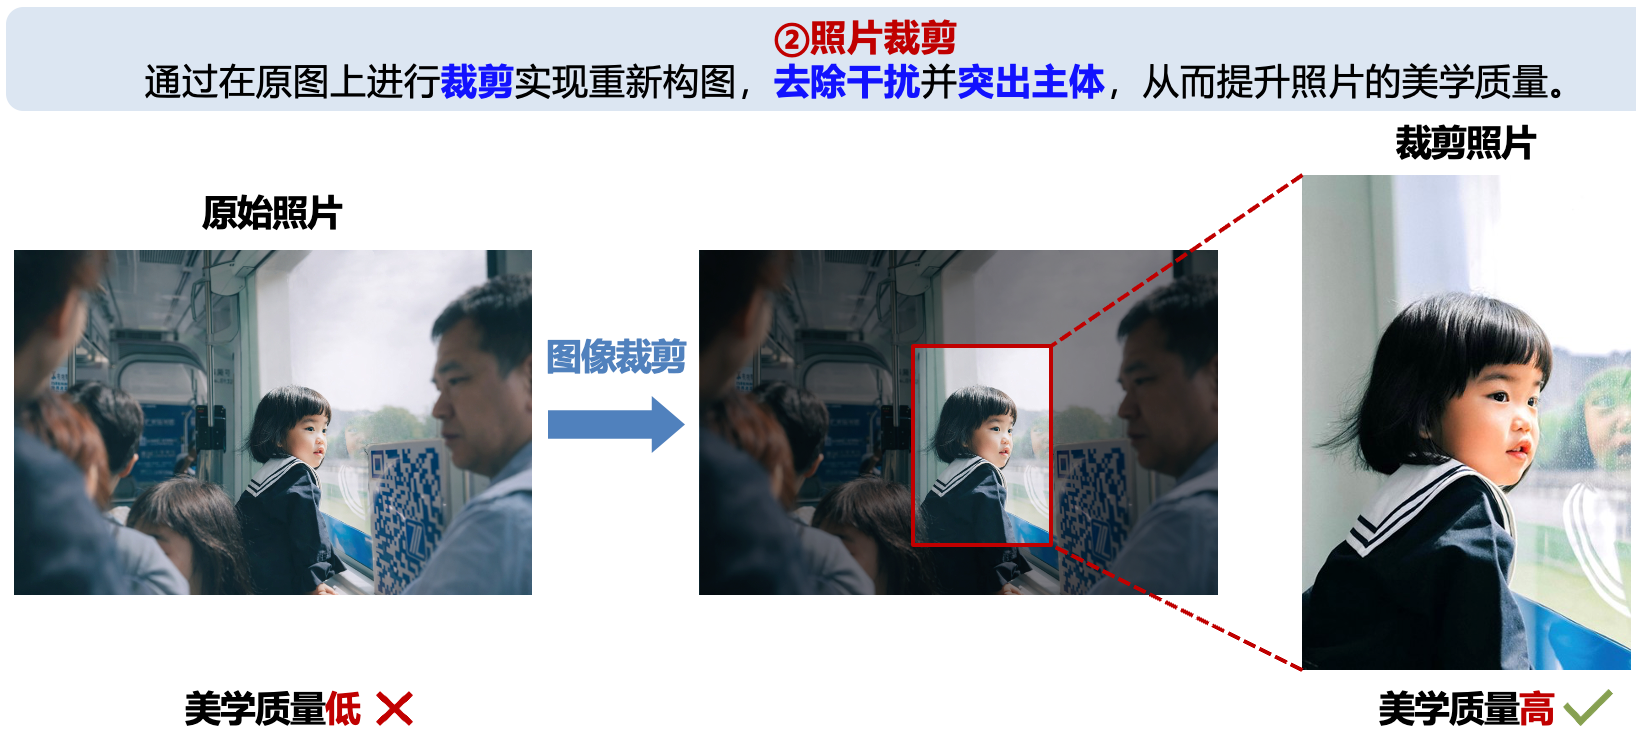
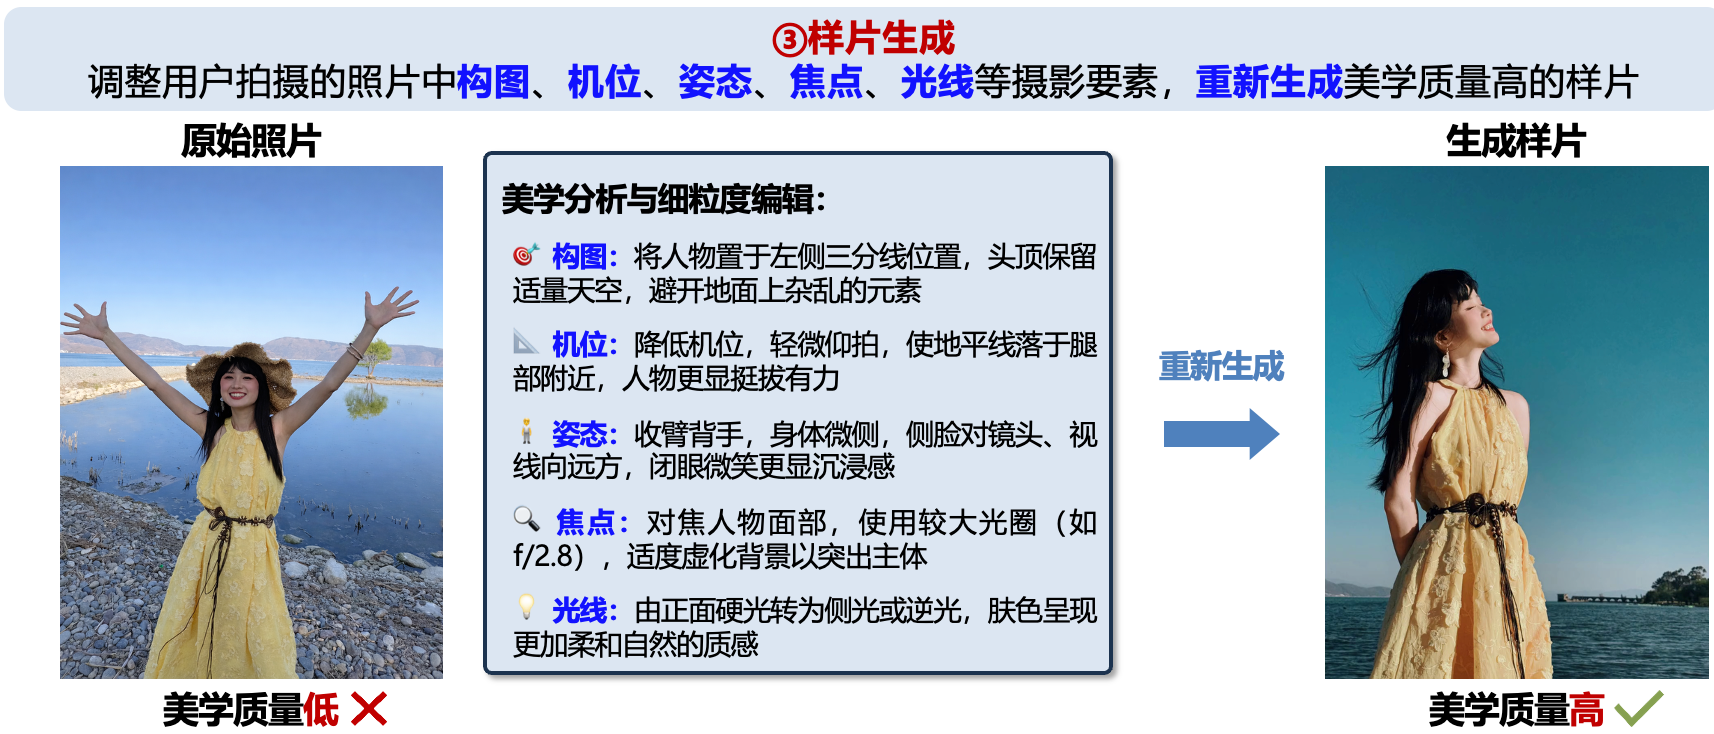
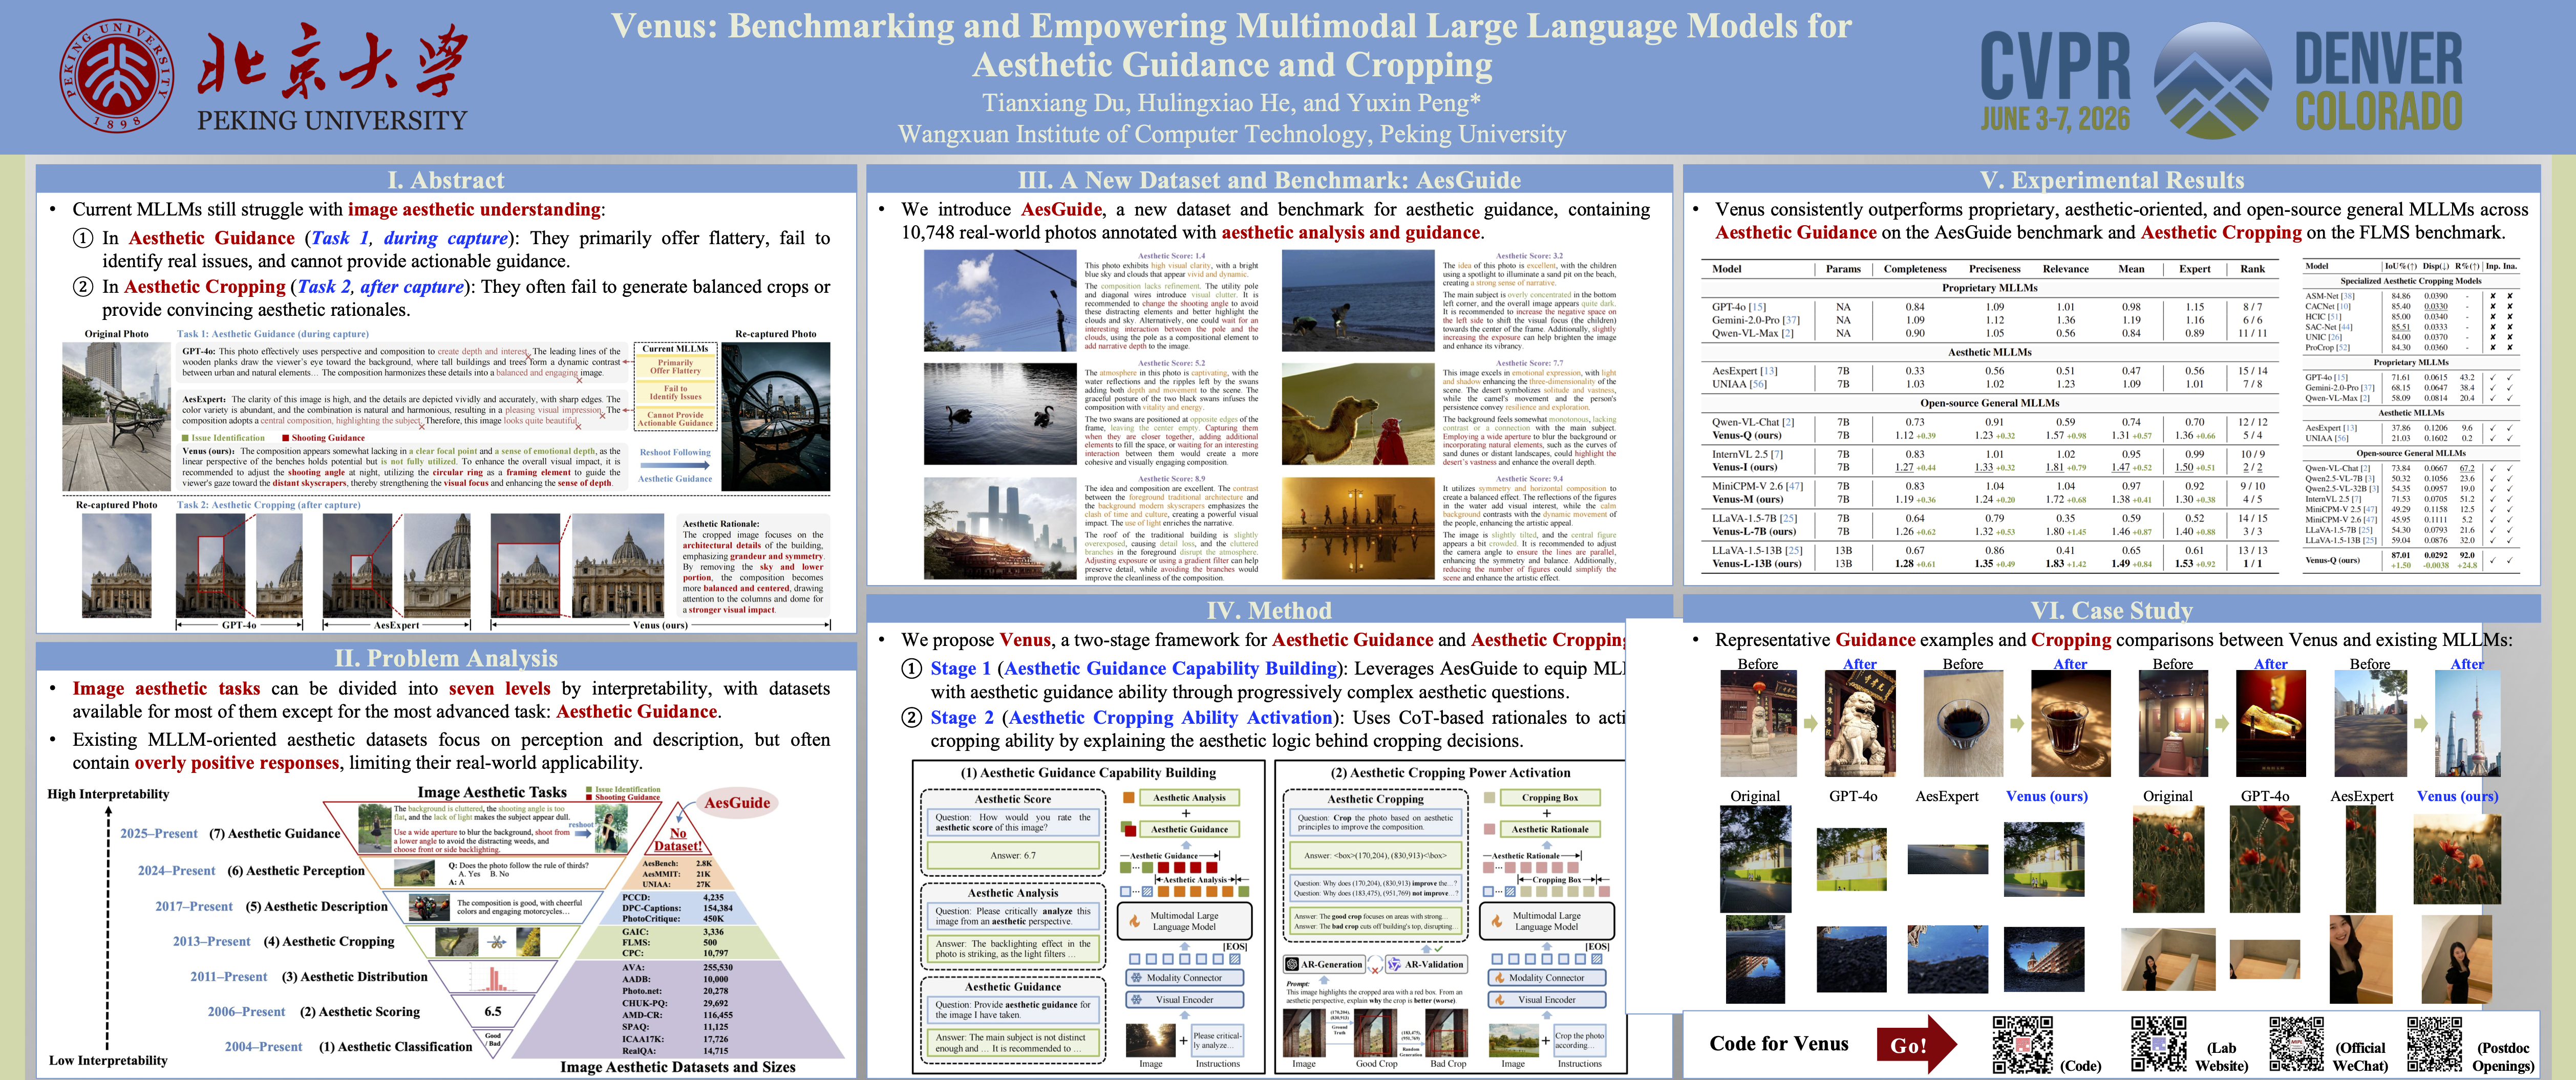
- 面向手机摄影的美学理解与创作技术: 智能手机让拍照越来越容易,但拍出一张好照片仍然很难。高质量摄影需要综合把握构图、视角、光影等复杂要素,这需要充足的美学知识与摄影经验。而普通用户由于缺乏这些知识与经验,拍出的照片往往流于平淡、缺乏美感。为此,本成果聚焦于面向手机摄影的美学理解与创作技术,重点突破了3项核心能力:
- Tianxiang Du, Hulingxiao He and Yuxin Peng*, "AesFormer: Transform Everyday Photos into Beautiful Memories", Forty-Third International Conference on Machine Learning (ICML), Seoul, South Korea, Jul. 6-11, 2026. (Accept)【pdf】【source code】【新智元报道】
- Tianxiang Du, Hulingxiao He and Yuxin Peng*, "Venus: Benchmarking and Empowering Multimodal Large Language Models for Aesthetic Guidance and Cropping", The IEEE/CVF Conference on Computer Vision and Pattern Recognition 2026 (CVPR), Denver CO, USA, Jun. 3-7, 2026. 【pdf】【source code】【CVPR海报】【量子位报道】【CCIG海报】
- 美学指导数据集和评测基准AesGuide(2026年3月发布,已被哈佛大学、麻省理工学院、华为、美图、三星、视觉中国等54个机构使用)
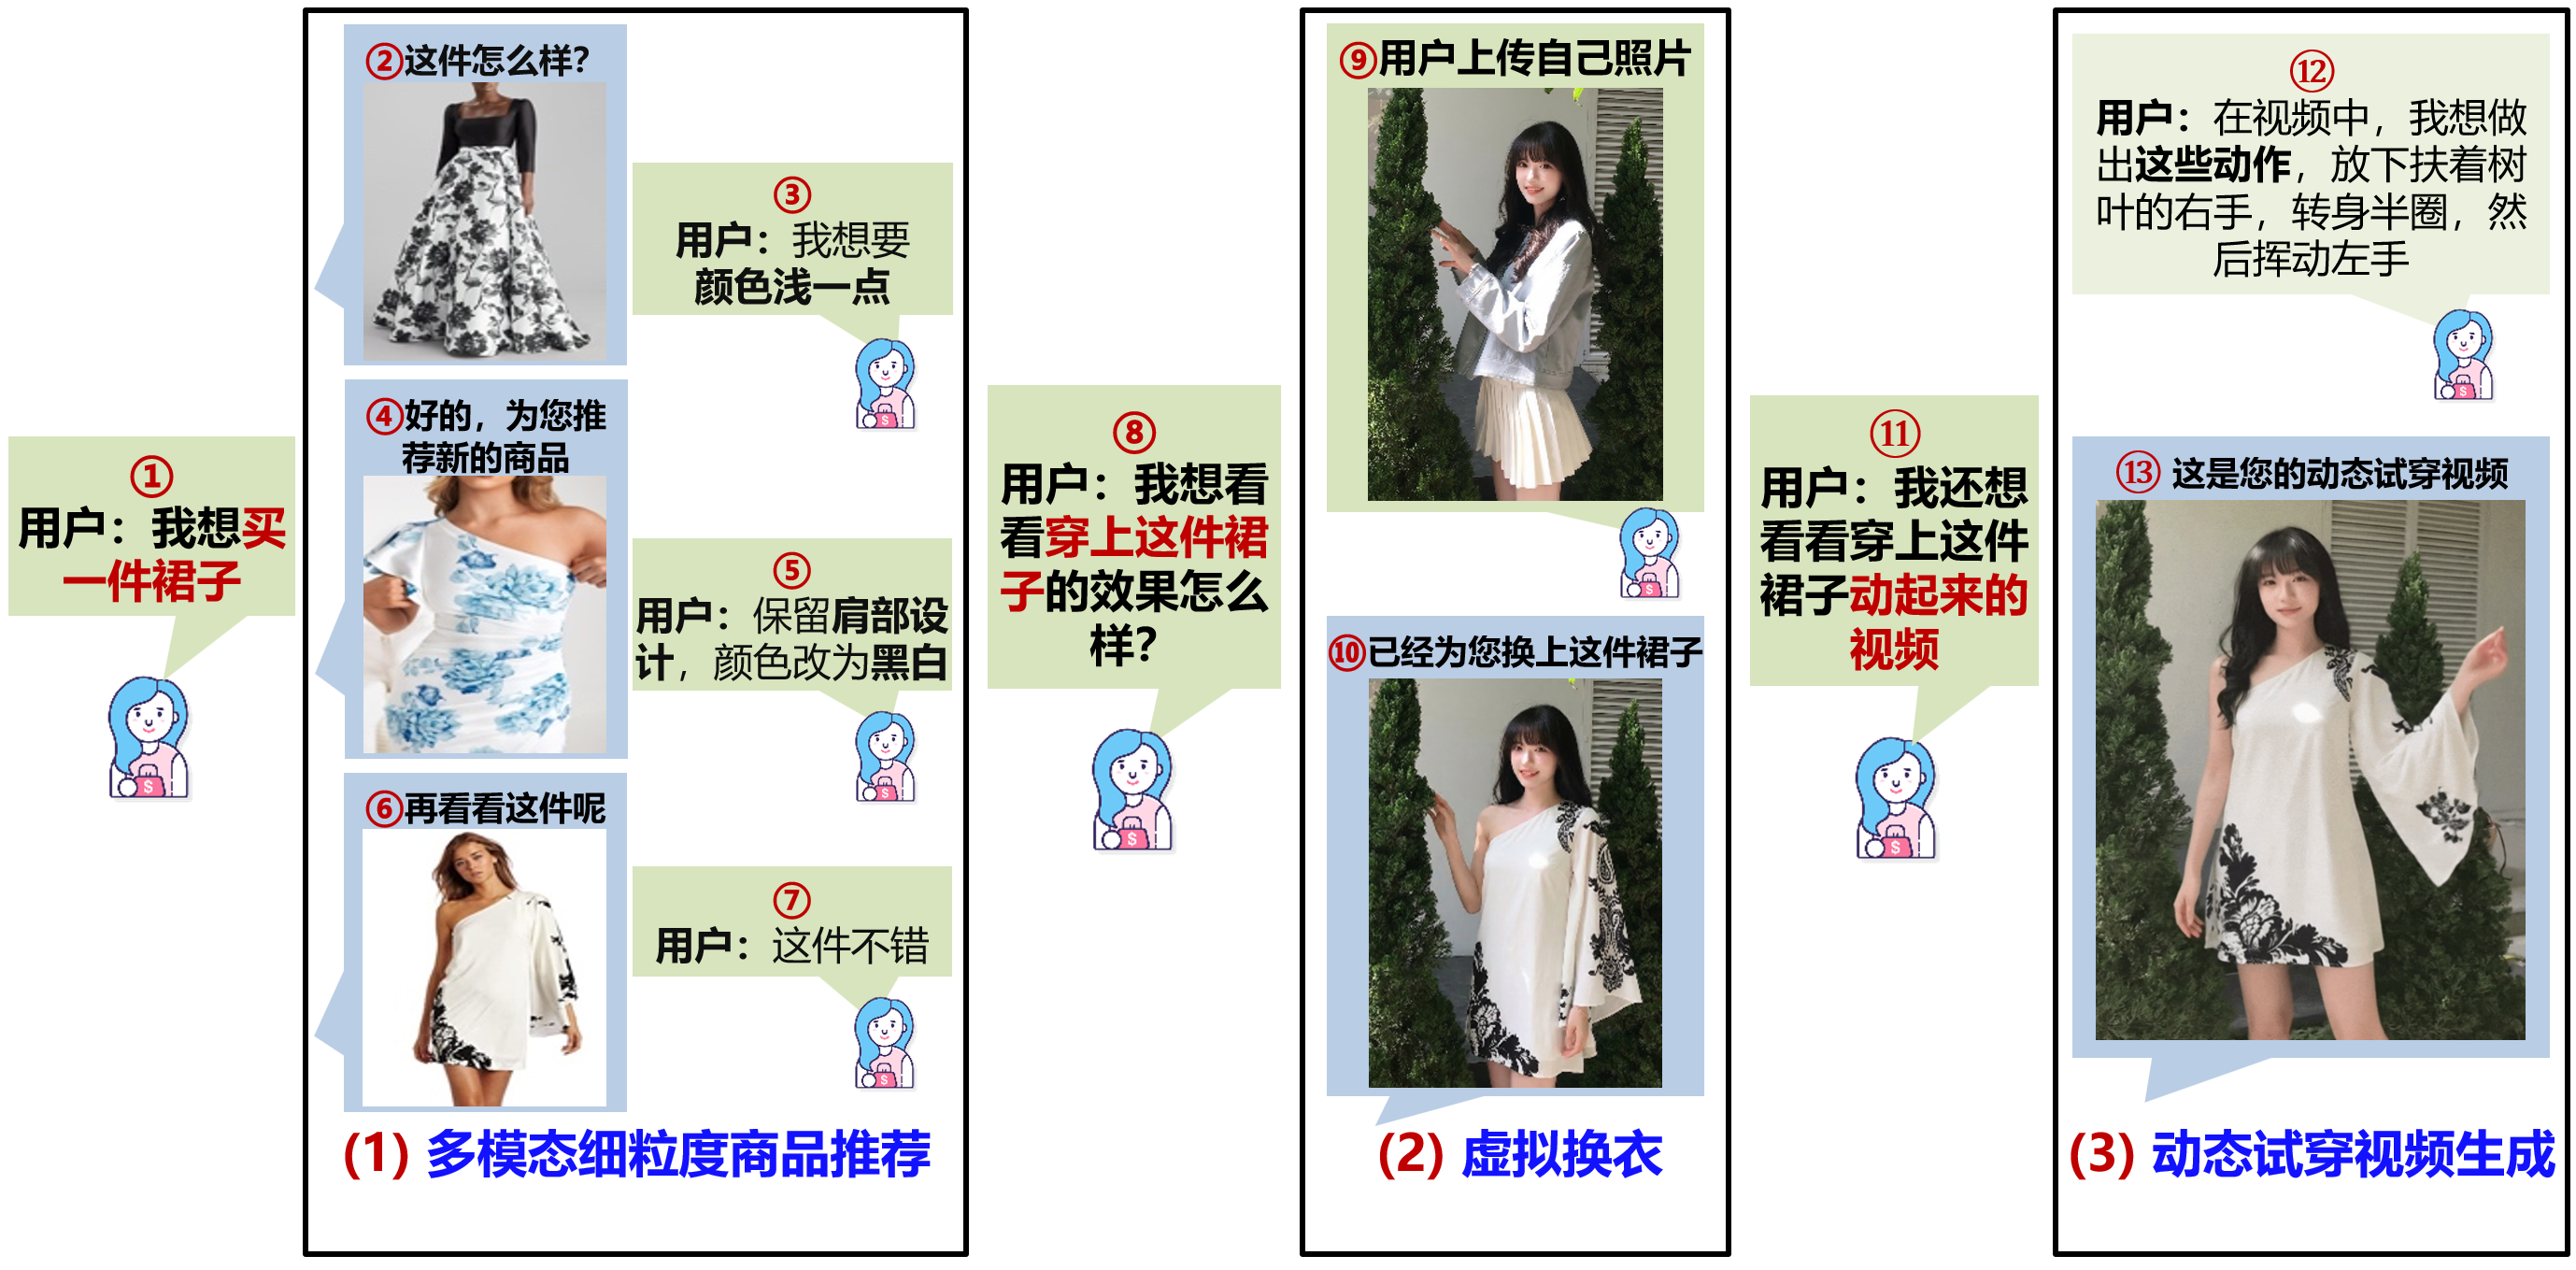
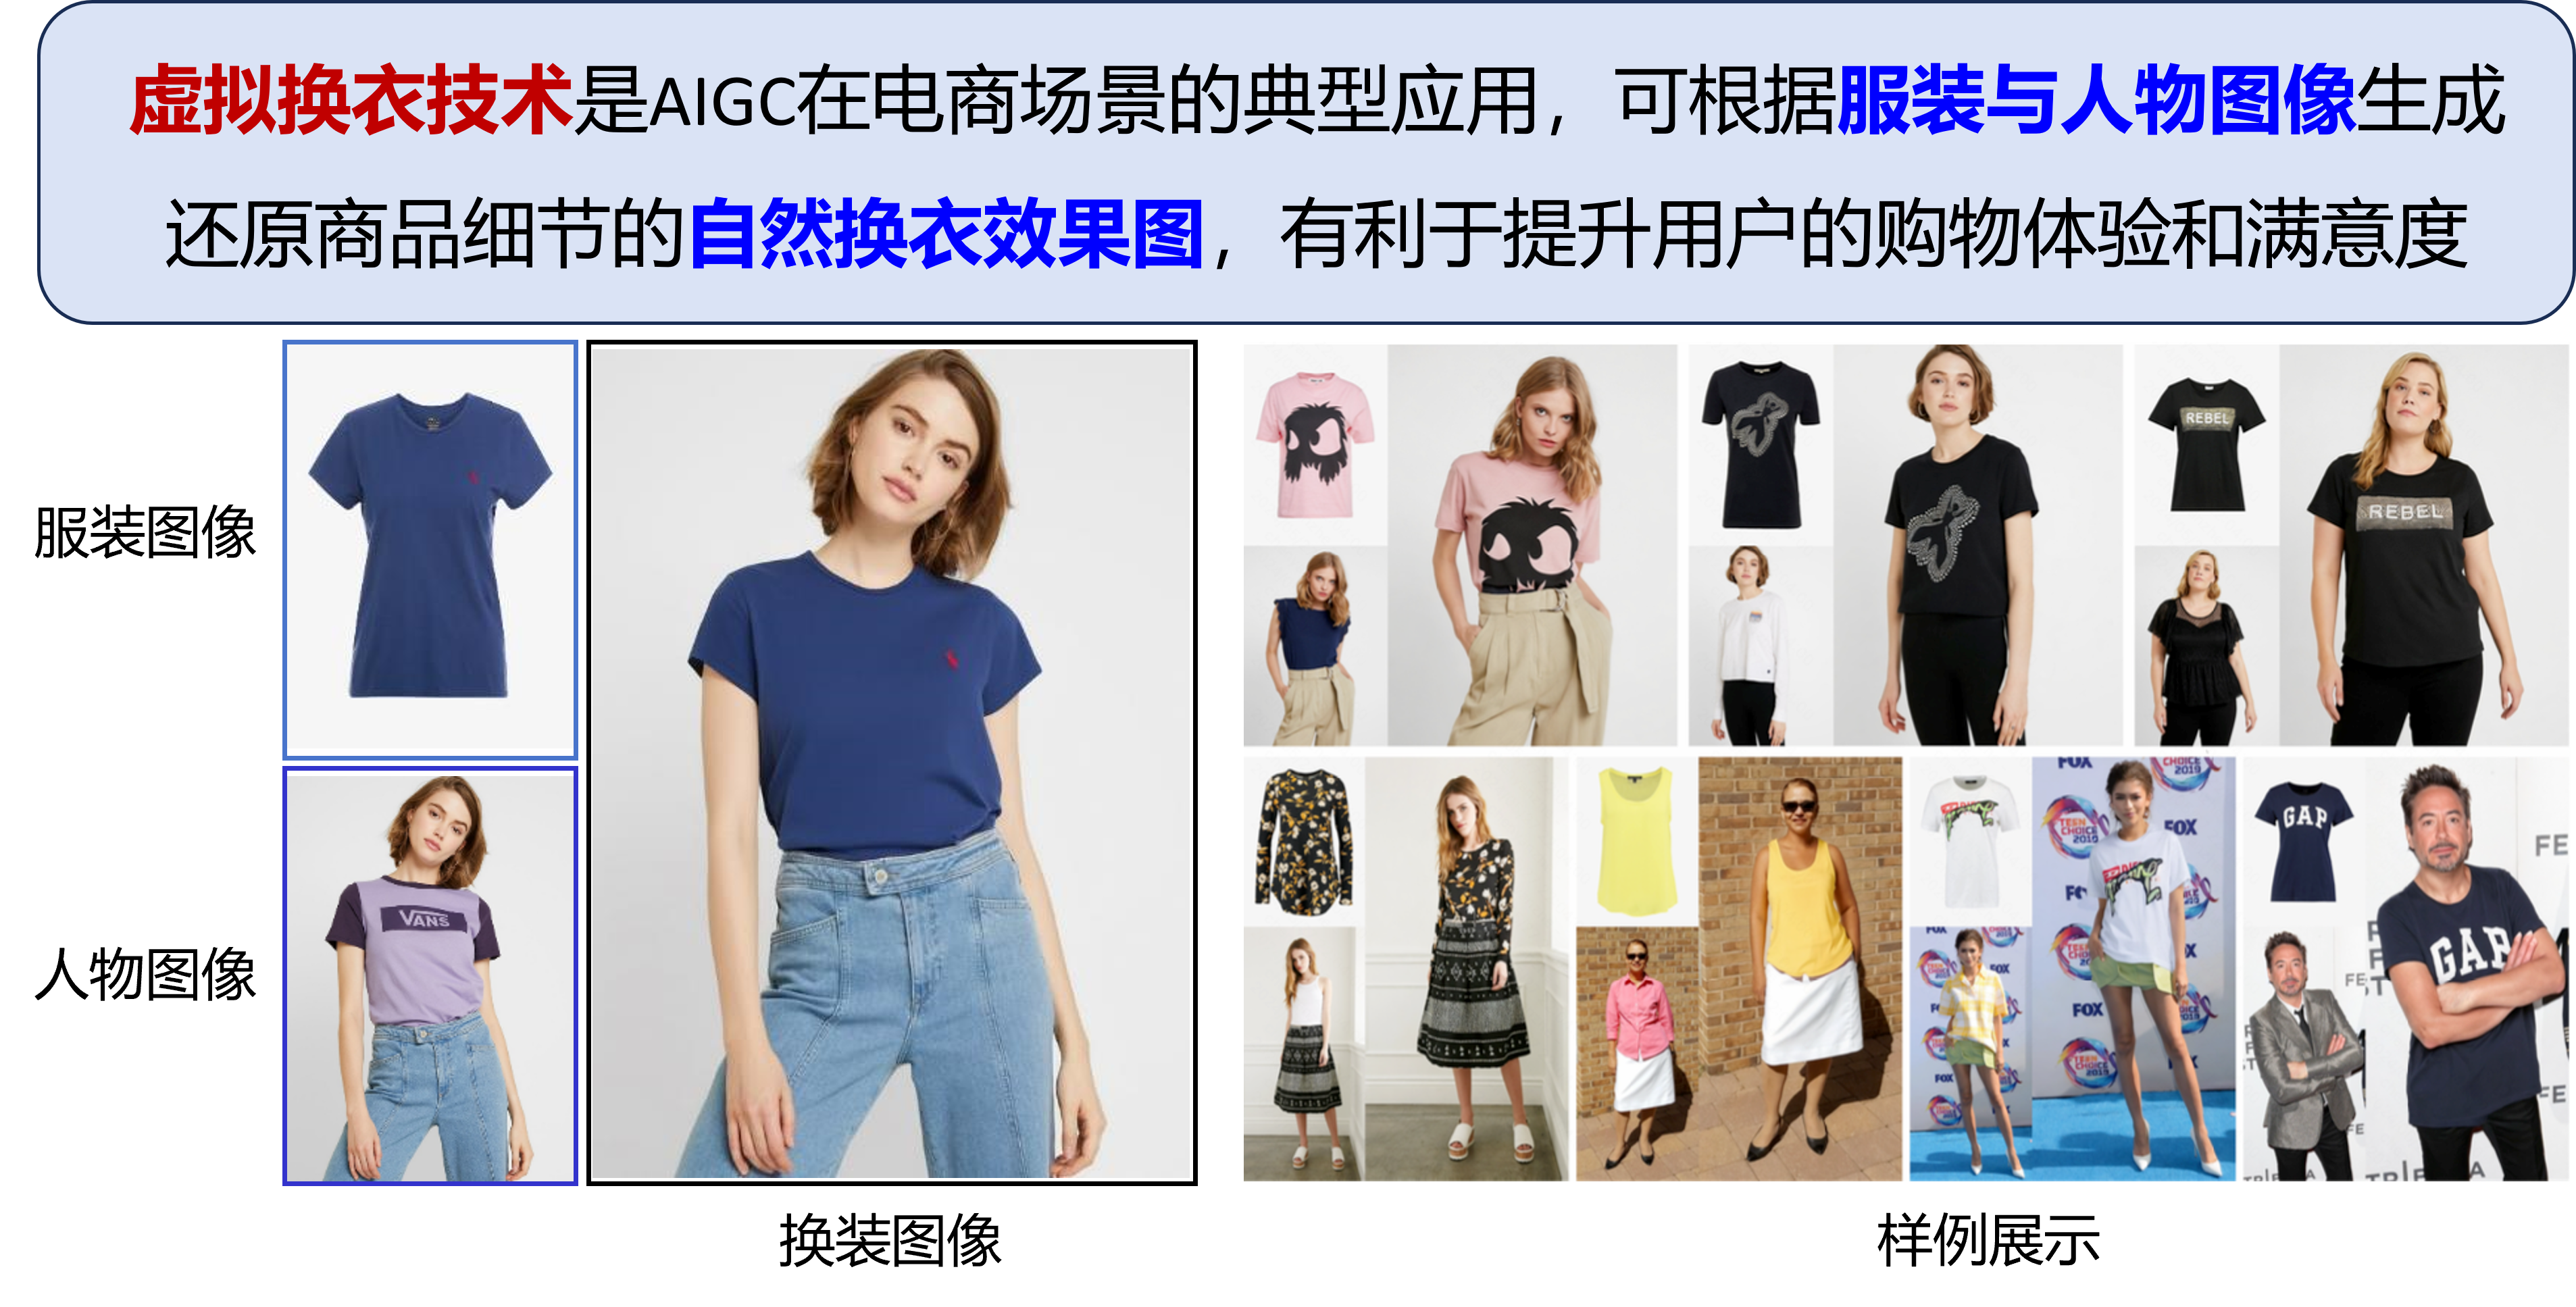
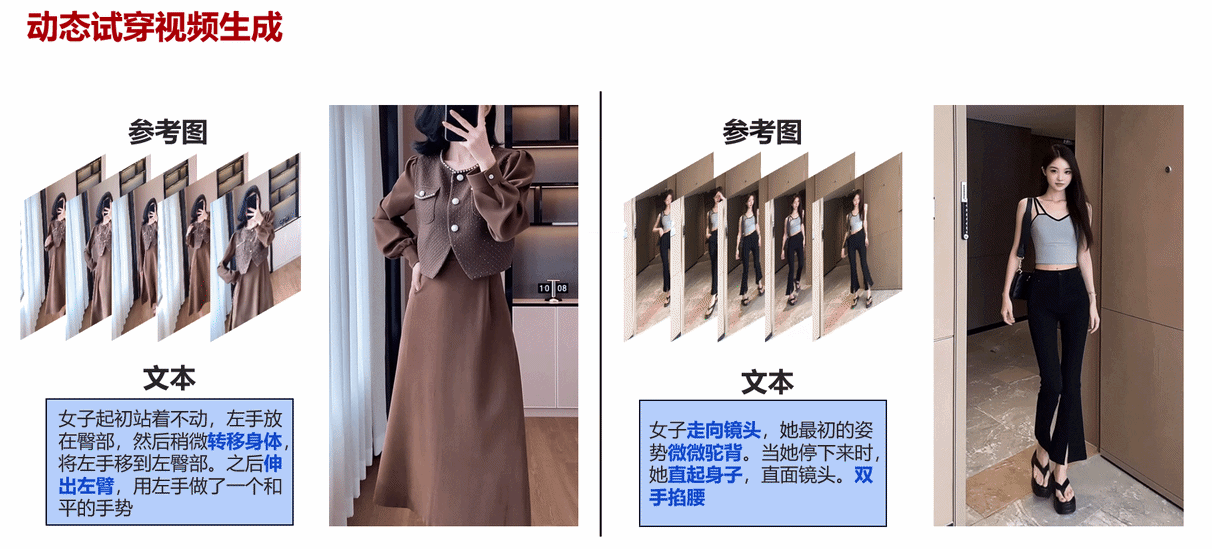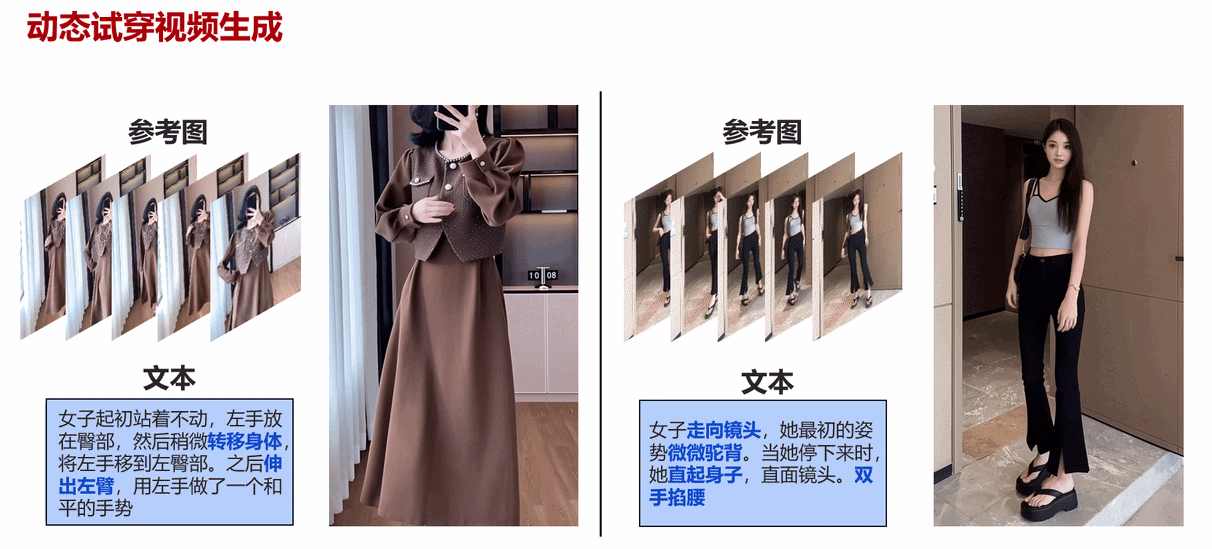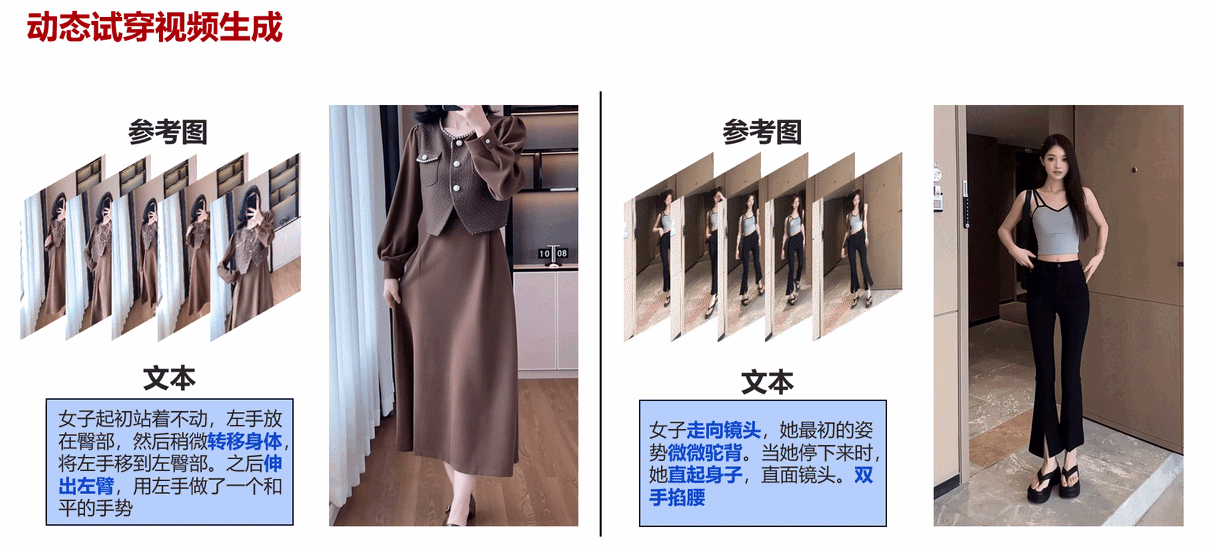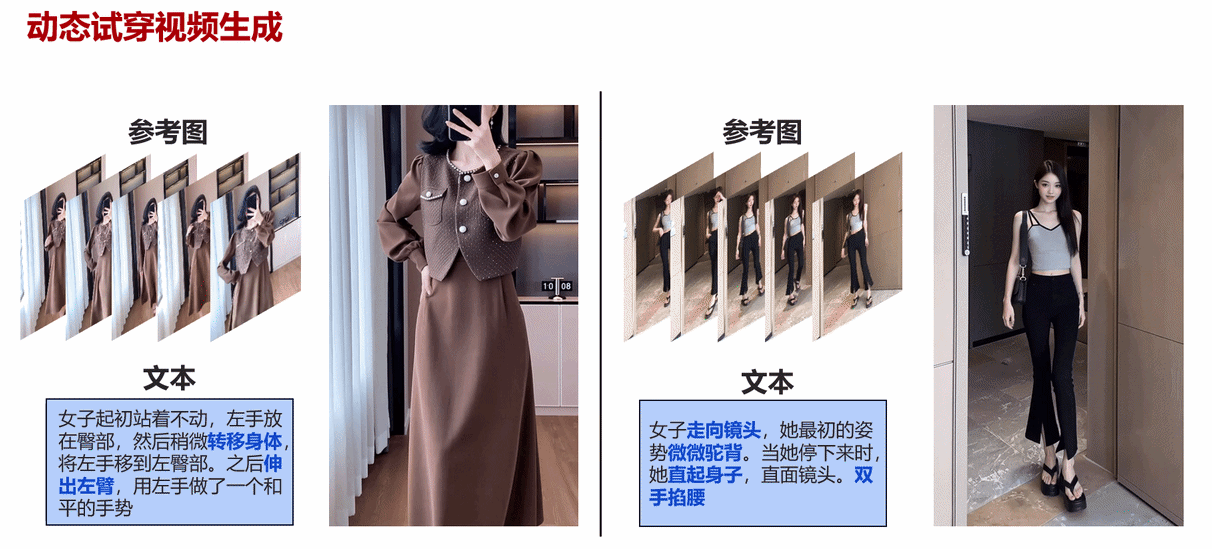
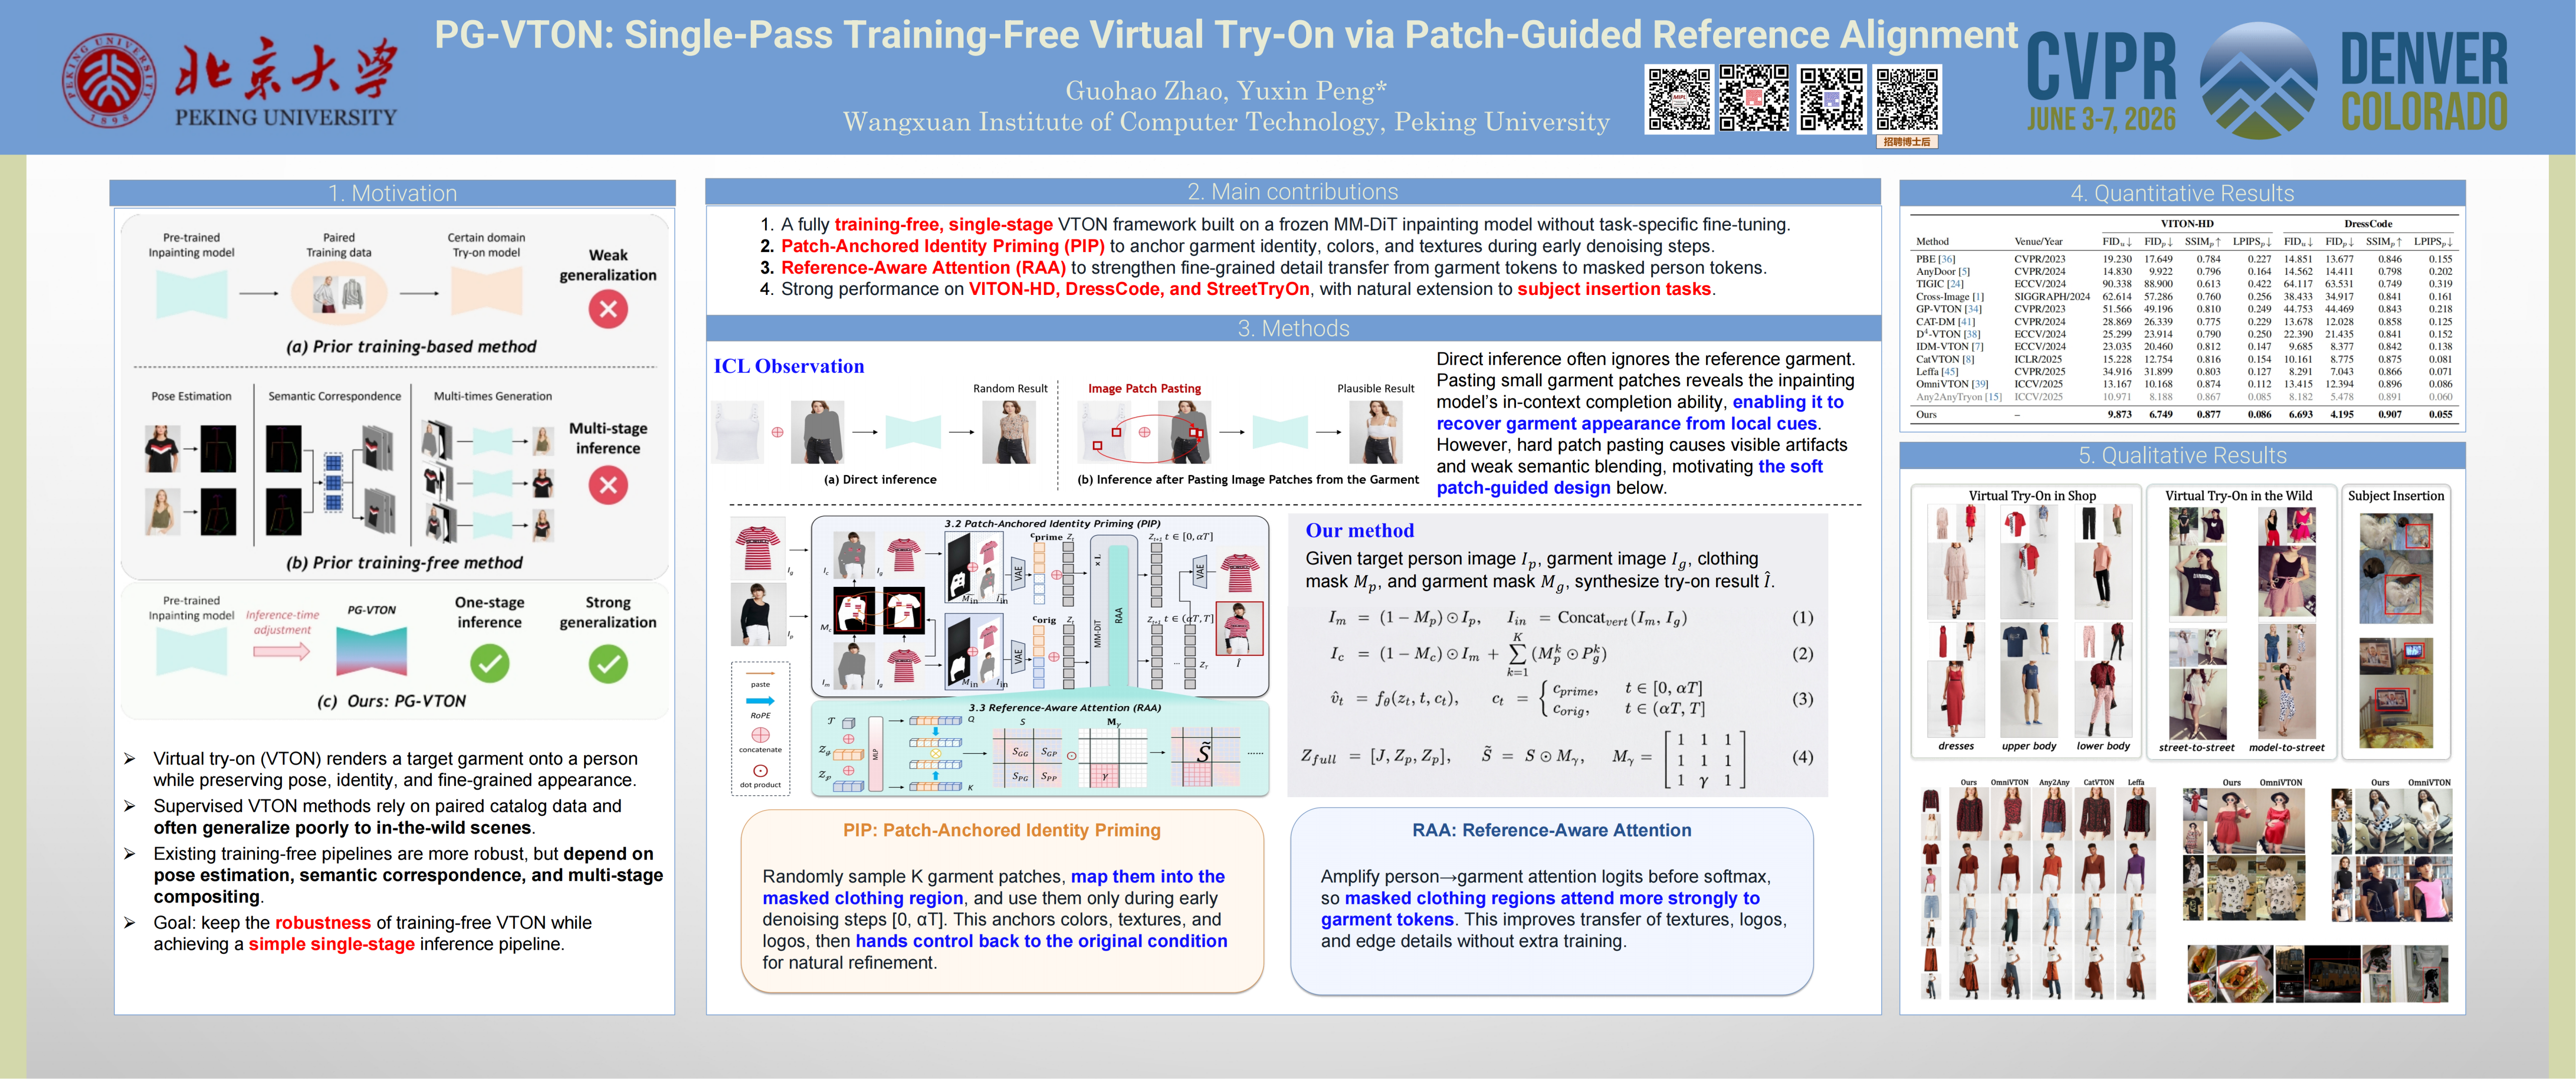
- 面向智能购物的多模态商品推荐与动态虚拟试穿技术: 随着多模态大模型与生成式人工智能的发展,线上购物正从传统商品搜索与静态浏览,向个性化、智能化和沉浸式体验转变。本成果围绕服装选购中的个性化需求,融合多模态理解与生成技术,实现从智能推荐、虚拟换装到动态试穿的一体化购物体验,重点突破了3项核心能力:
- Guohao Zhao and Yuxin Peng*, "PG-VTON: Single-Pass Training-Free Virtual Try-On via Patch-Guided Reference Alignment", The IEEE/CVF Conference on Computer Vision and Pattern Recognition 2026 (CVPR), Denver CO, USA, Jun. 3-7, 2026. 【pdf】【source code】【CVPR海报】【极市平台报道】【Valse海报】
- Yanzhe Chen, Zhiwen Yang, Jinglin Xu and Yuxin Peng*, "MAI: A Multi-turn Aggregation-Iteration Model for Composed Image Retrieval", The Thirteenth International Conference on Learning Representations (ICLR), Singapore, Apr. 24-28, 2025. 【pdf】【source code】【CSIG报道】【机器之心报道】【宣传海报】
- 广告海报内容感知布局生成的数据集和评测基准PKU PosterLayout(2023年7月发布,已被卡内基梅隆大学、微软、谷歌Deepmind、Adobe、Apple等146个机构使用)
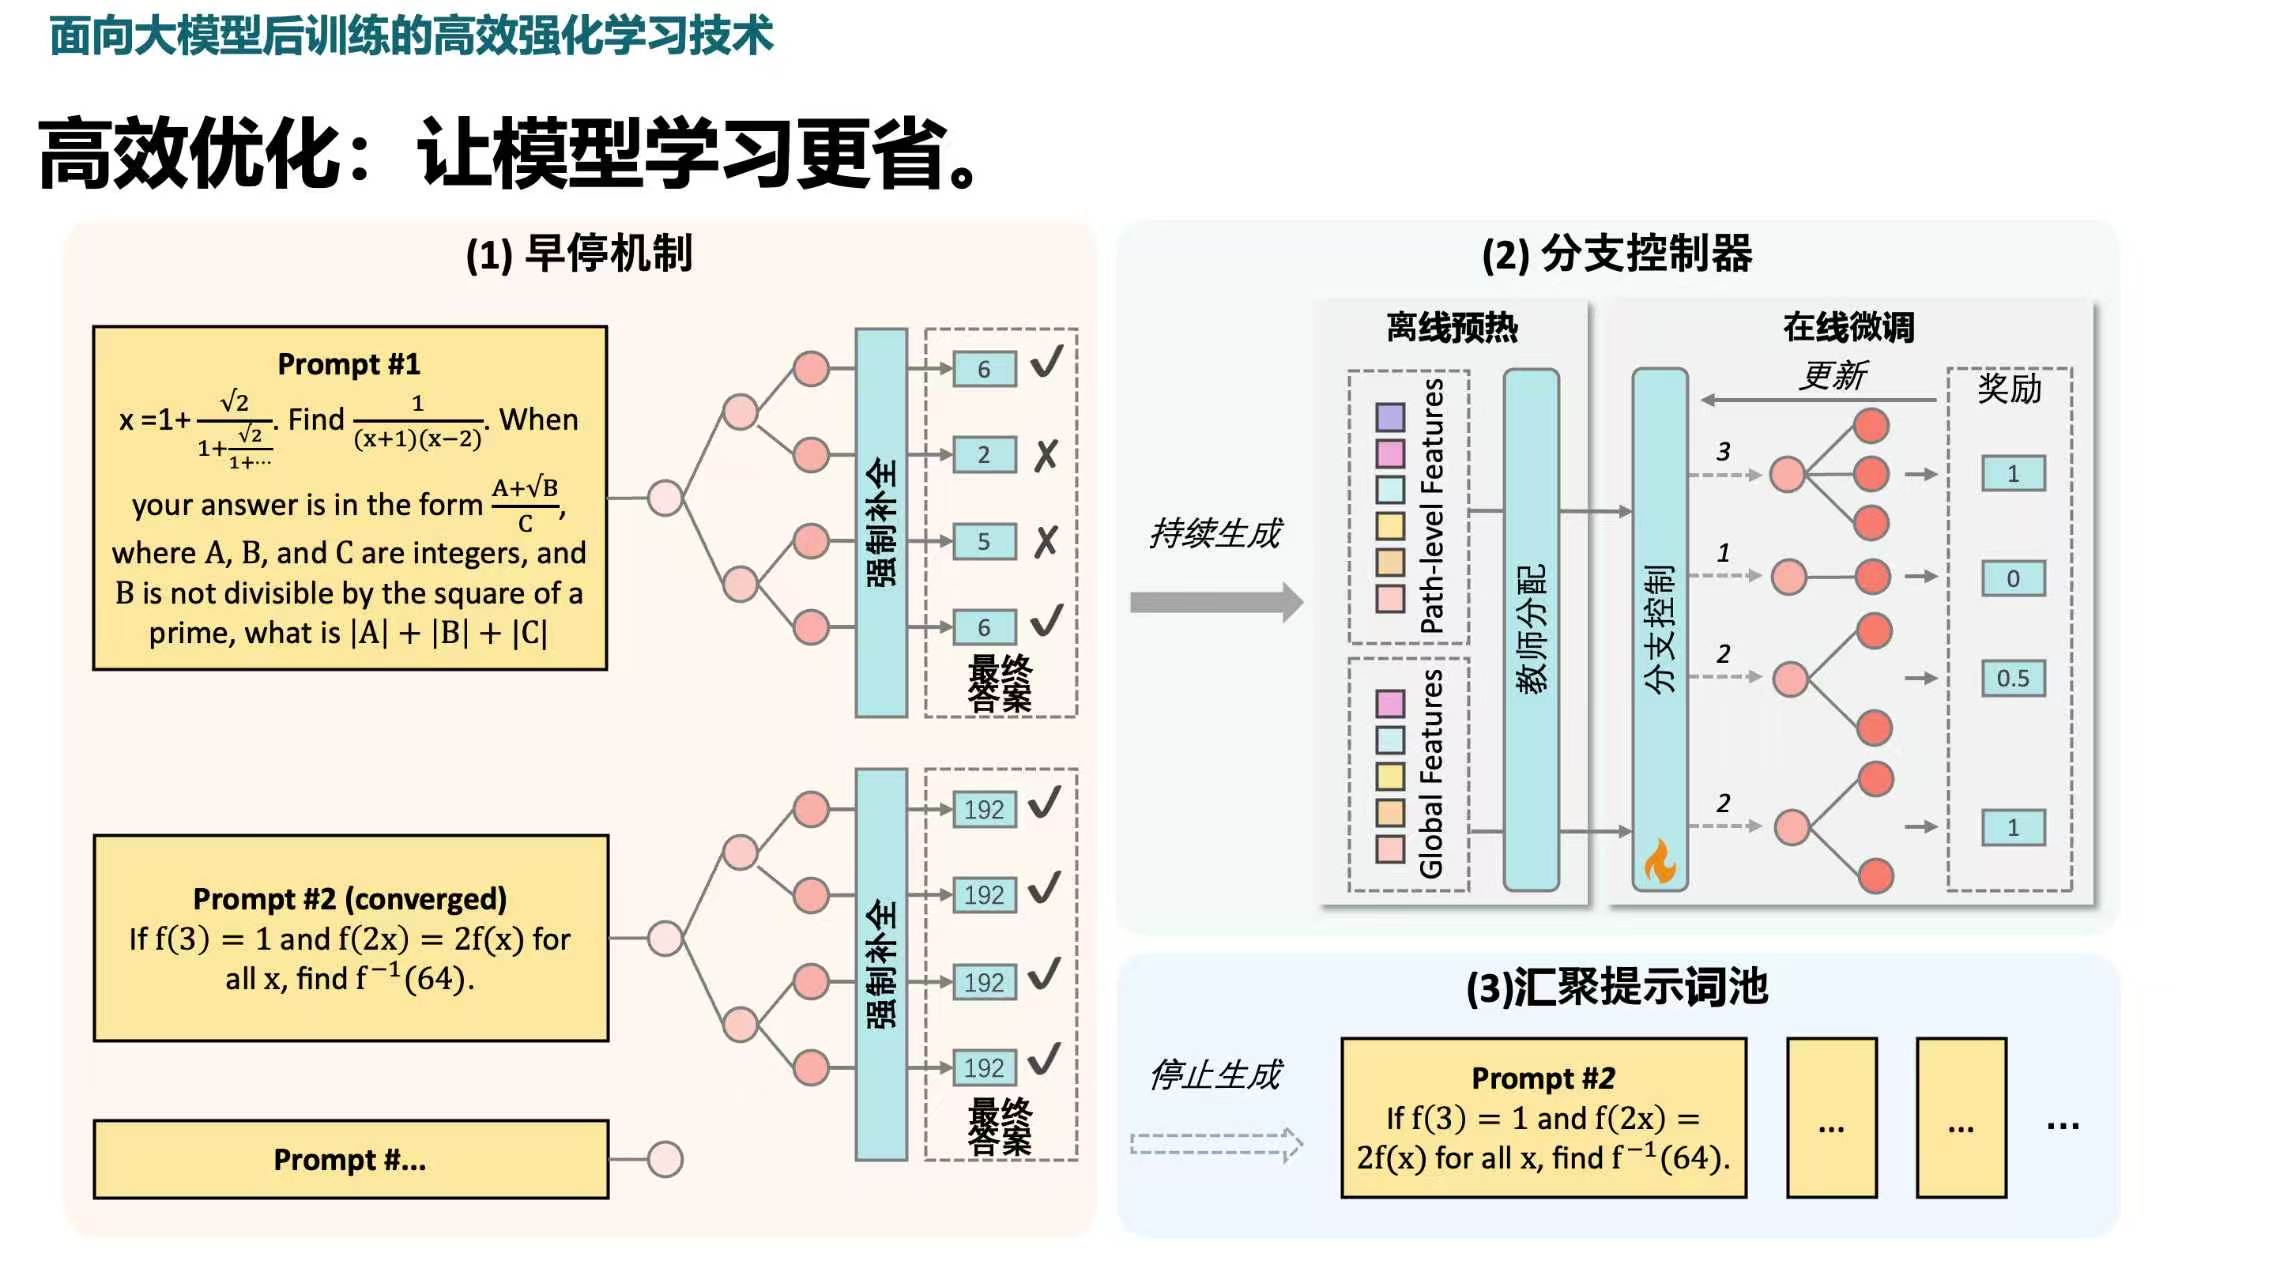
- 面向大模型后训练的高效强化学习技术: 随着人工智能从“会聊天”向“能办事”加速演进,复杂推理与任务执行成为大模型能力提升的重要方向。强化学习通过持续探索与反馈推动模型进步,但海量响应生成和反复训练产生的高昂算力开销,制约了模型能力的持续提升。为此,本成果聚焦于面向大模型后训练的高效强化学习技术,重点突破2项核心能力:
- Shengpeng Yin, Hui-Ling Zhen, Xing Li, Mingxuan Yuan, Zishuo Wang and Yuxin Peng*, "LADDERS: Length-Aware Data Distribution and Existing-Response Speculation for Fast RL Rollout Generation", The Fortieth Annual Conference on Neural Information Processing Systems (NeurIPS), 2026. (Accept)
产业合作:
近年来,MIPL研发了“面向个人智能助手的多模态视觉记忆技术”、“面向下一代智能终端的细粒度感知与记忆技术”、“面向手机摄影的美学理解与创作技术”、“面向智能购物的多模态商品推荐与动态虚拟试穿技术”和“面向大模型后训练的高效强化学习技术”等成果。其中,开源的Finedefics是业内首个细粒度多模态大模型;开源的细粒度识别大模型Fine-R1是首个在该任务上超越OpenAI的CLIP、Google DeepMind的SigLIP2等判别式模型的生成式大模型,开源1周内达到万级下载量,单月累计下载量达2.37万次;开源的基于细粒度树的分层识别方法TARA首次将大模型的识别范围从最细粒度的根节点拓展到了整棵类别树。期待与企业开展产业合作,推动技术创新与成果转化。
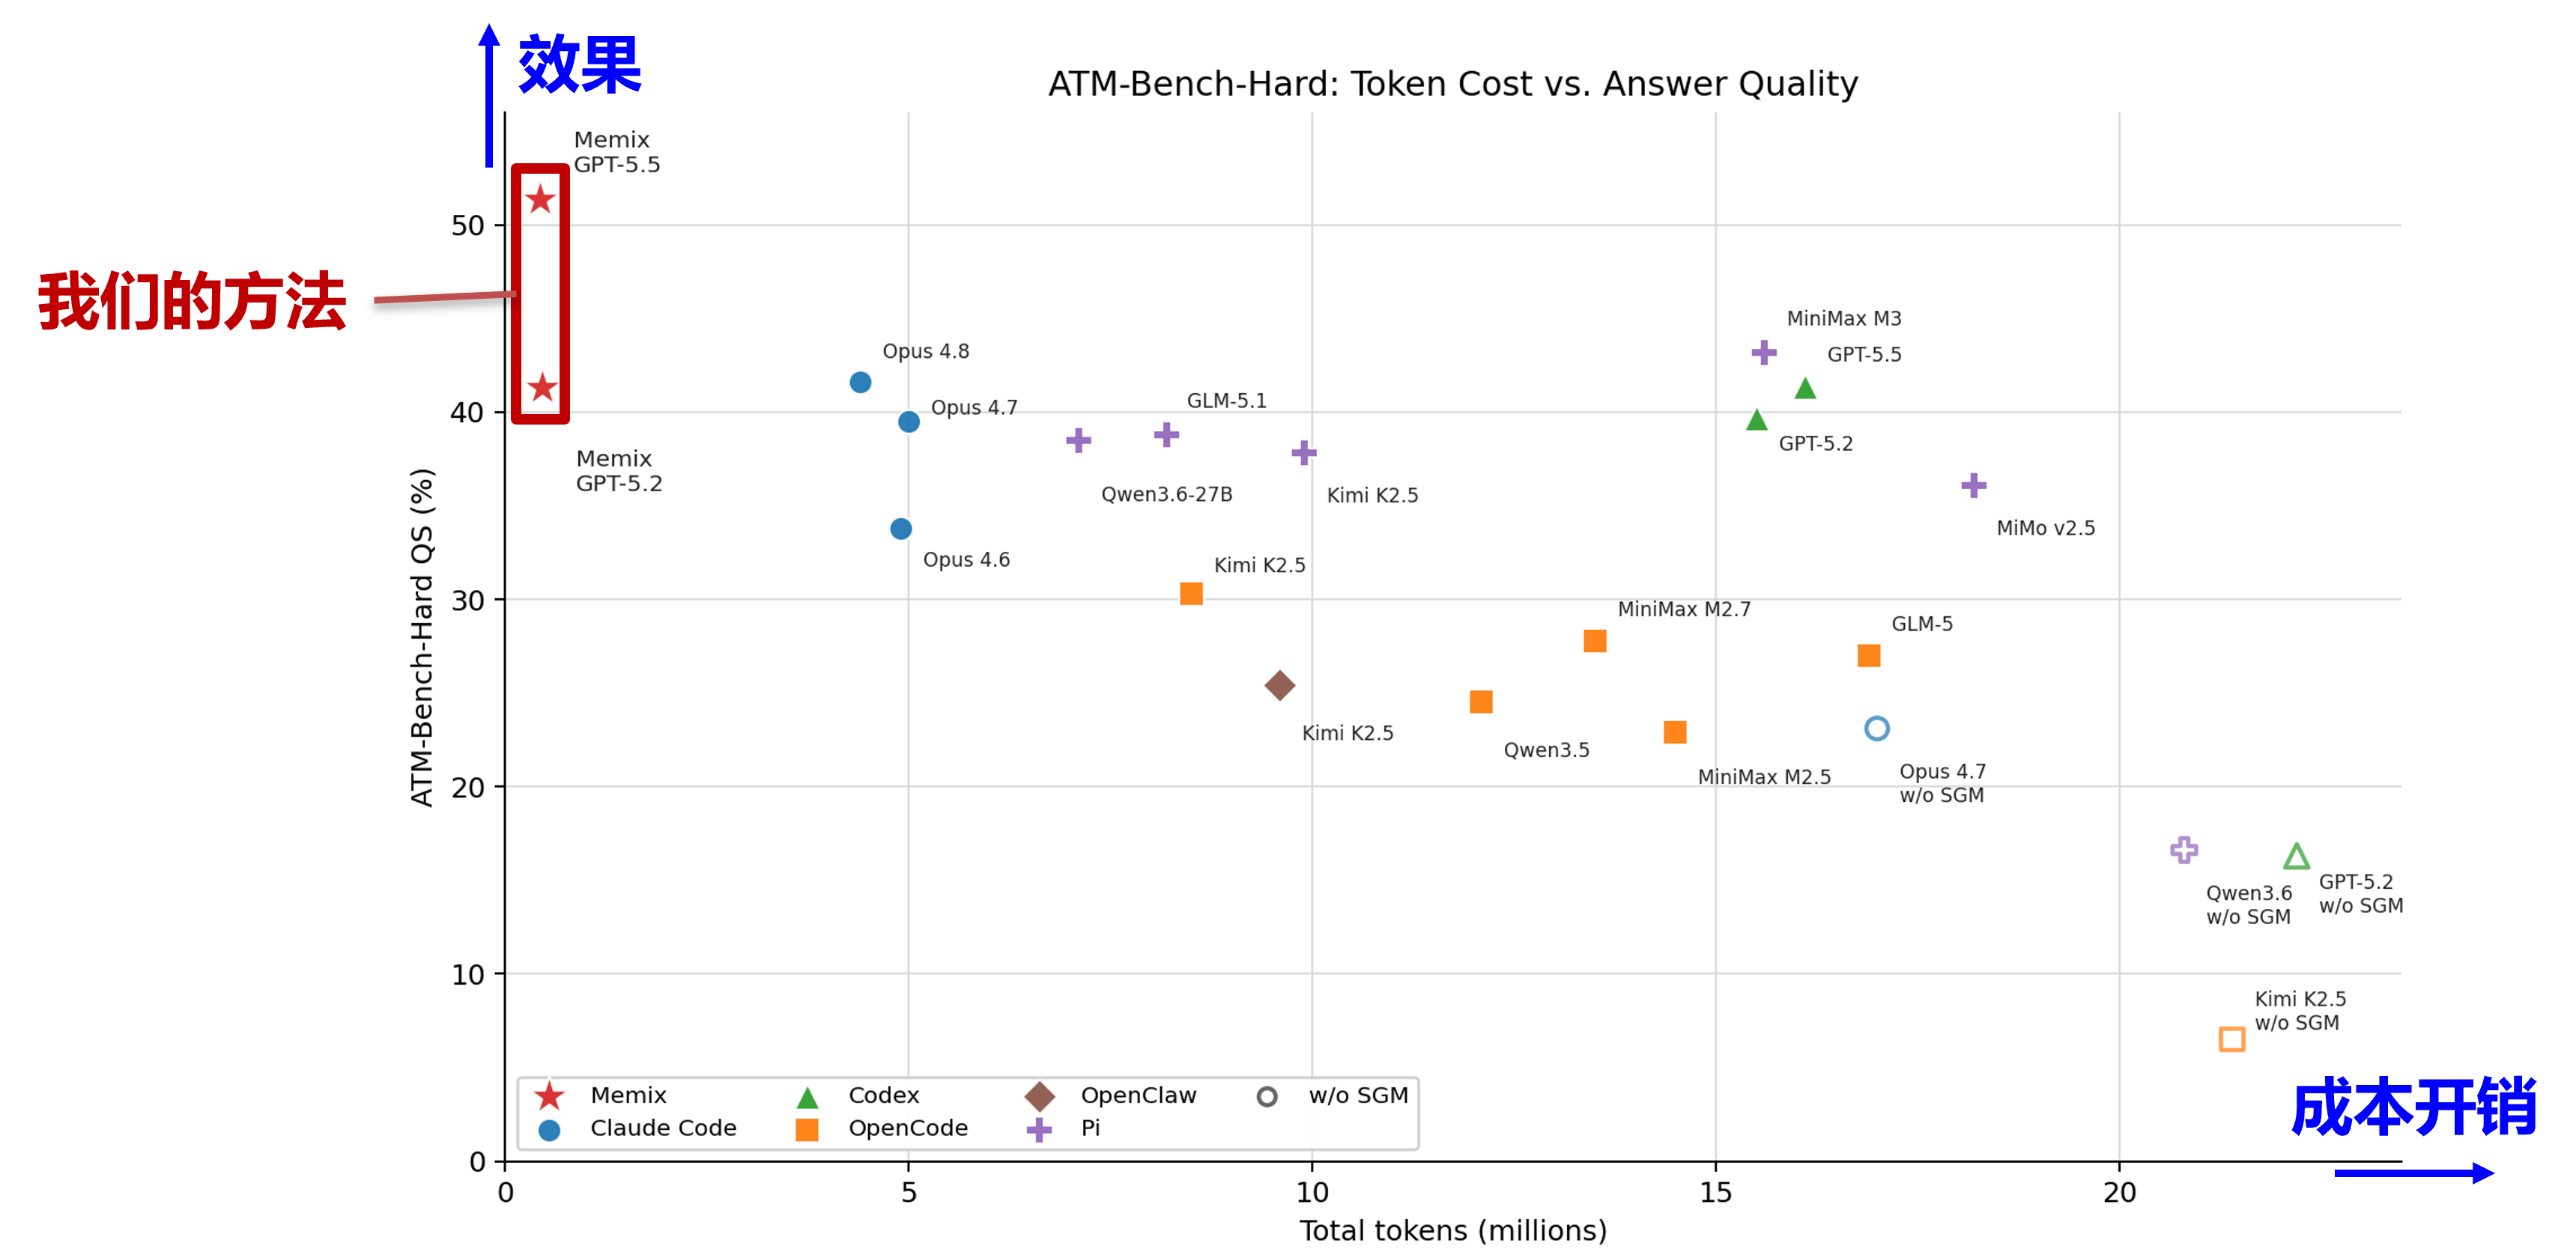
(1)个性化视觉记忆:统一构建照片、视频、邮件、对话等多模态个人记忆,完整保留图像细节,使 AI 能够准确识别与用户相关的人、物和场景,在ATM-Bench、Mem-Gallery、MemEye、H2HMem等多个权威记忆榜单上取得第1名(包括腾讯、蚂蚁集团、UC伯克利大学、剑桥大学等12支队伍)。
近期相关论文:
(1)细粒度感知:实时看清世界。面向连续视频流,模型边看边理解,实时追踪人物、物体、动作及细微状态变化,理解事件的时序关系与动态演进,并随新信息持续更新判断。不仅能随时响应用户提问,还能主动捕捉关键事件,判断何时提醒、何时沉默、何时修正,实现与真实世界同步、自然流畅的交互。
近期相关论文:


近期相关论文:
(1)细粒度商品推荐:让选购更精准。融合图像理解与多轮对话,精准识别服装款式、颜色、纹理及局部设计等细粒度属性。用户可通过自然语言不断调整偏好,实现更加灵活、精准的个性化商品推荐。
近期相关论文:
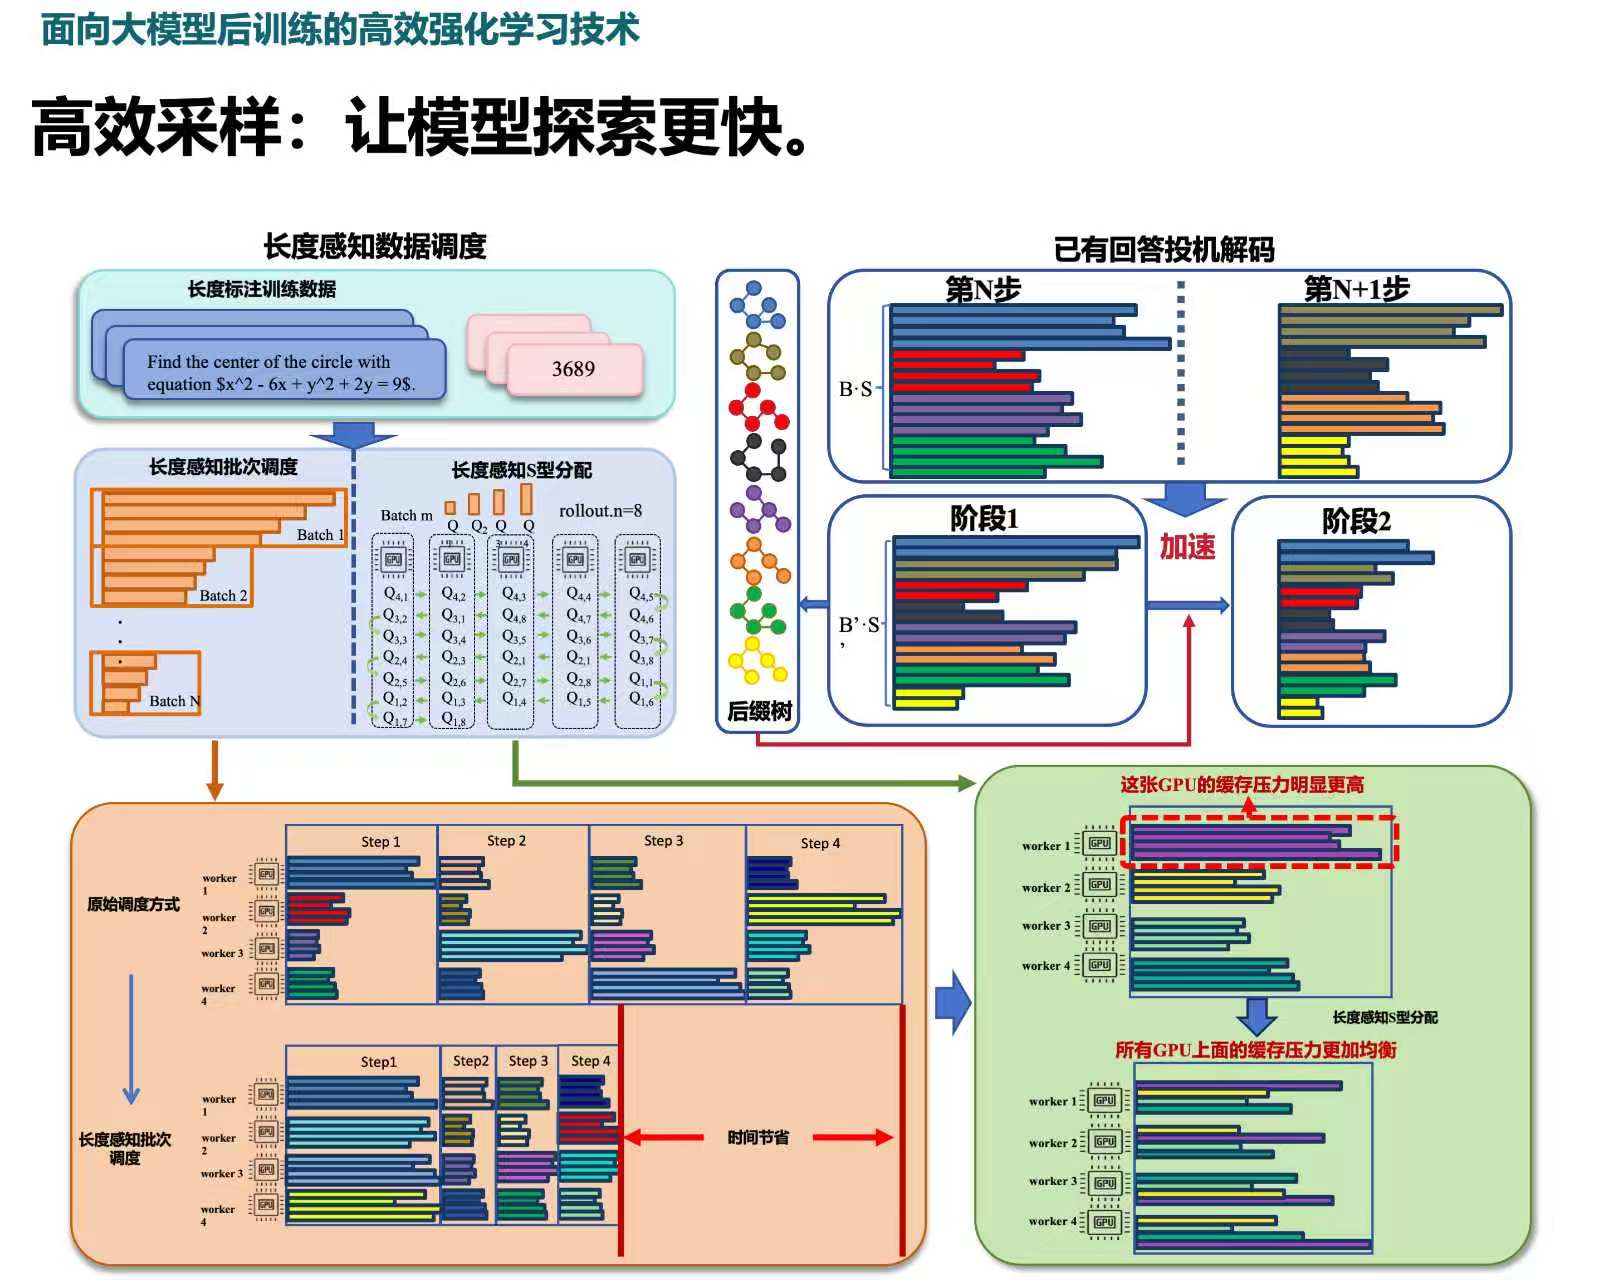
(1)高效采样:让模型探索更快。强化学习需要模型反复尝试、生成大量候选回答,容易造成计算资源等待和浪费。本成果通过智能协调生成任务、均衡计算负载,提高资源利用效率;同时挖掘历史探索结果中的可复用信息,减少重复生成,让模型用更少时间完成更多有效尝试,在兼顾生成质量的同时降低采样成本。
近期相关论文: